


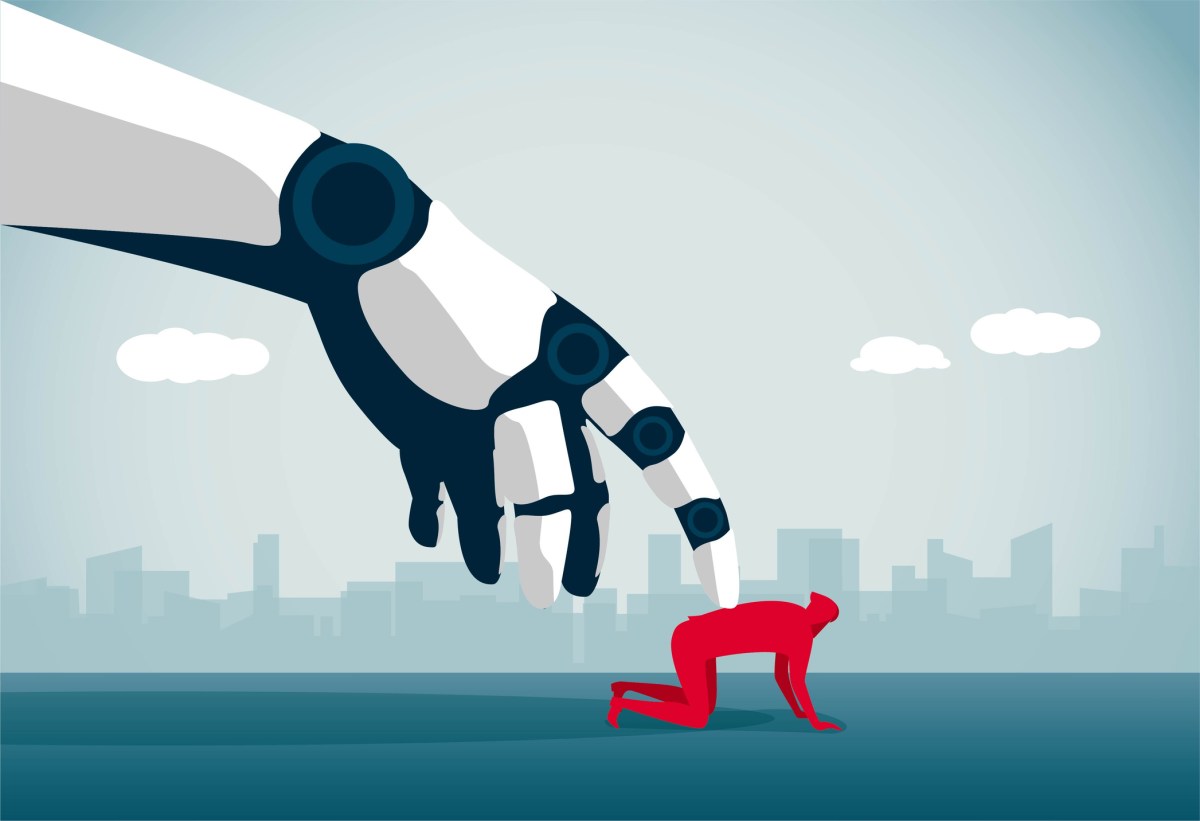
Industrija umjetne inteligencije nikad nije bila glasnija u raspravi o tome predstavlja li njezina tehnologija egzistencijalnu prijetnju čovječanstvu.
Sve je počelo kada je istraživač AI-ja Jacob Coxon objavio da je dao otkaz u Anthropicu jer smatra da vodeće AI kompanije “kockaju našim životima.” Potom se oglasio voditelj tima za usklađivanje u Anthropicu objavom na mreži X u kojoj je napisao: “Doista iskreno vjerujemo da bi AI mogao pobiti sve ljude!” — dodavši da osobno procjenjuje tu vjerojatnost na “više od 10% u sljedećem desetljeću.”
U najnovijem izdanju TechCrunchevog podcastа Equity, Kirsten Korosec, Sean O’Kane i ja razgovarali smo o tim apokaliptičnim upozorenjima. Pokušao sam objasniti zašto sam skeptičan prema narativima o propasti koje šire zagovornici AI-ja, dok je Kirsten postavila pitanje je li to možda “samo čudan način hvalisanja naprednim sposobnostima njihovih modela” — posebno u trenutku kada se te kompanije pripremaju za izlazak na burzu.
Sean se zapitao kako bi ti stavovi mogli biti prikazani u Anthropicovom S-1 prospektu za IPO: “Postoje li mladi odvjetnici koji upravo sada prolaze kroz cijeli taj odjeljak S-1 dokumenta i moraju ga prepisati da stoji: ‘Anthropicov je službeni stav da postoji više od 10% vjerojatnosti da bismo mogli razviti nešto što bi istrijebilo cijelo čovječanstvo, što bi materijalno štetilo našem poslovanju’?”
U nastavku donosimo skraćeni i uređeni pregled tog razgovora. (Napomena: Epizodu smo snimili prije nego što je Anthropicov izvršni direktor Dario Amodei objavio svoj plan za opreznije razvijanje AI-ja.)
Sean O’Kane: Teško mi je sjetiti se nečega što je ovako brzo eksplodiralo. Nije samo to što je ovo upozorenje stiglo od mladog istraživača koji je radio i u OpenAIu — nego ga je odmah podijelio voditelj tima za usklađivanje u Anthropicu. I to s uskličnikom koji bi mogao ući u povijest kao jedan od najpogrešnije postavljenih uskličnika ikad: podijelio je Coxonovu objavu i niz tweetova uz komentar “Doista iskreno vjerujemo da bi AI mogao pobiti sve ljude!” Uskličnik!
Kakva čudna atmosfera. To je bio pravi benzin na ionako napetu situaciju. Sve to dolazi nakon hakiranja Hugging Facea putem OpenAIjevog internog modela, uz sve veće sposobnosti koje vidimo kod najnovijih modela koje su objavili Anthropic i OpenAI s Astrom prije nekoliko tjedana — mislim da je ovaj mladi istraživač pogodio savršen trenutak da sve to eksplodira.
Anthony Ha: Moram se s tobom malo posvađati — ako doista vjeruješ da bi AI mogao uništiti cijelo čovječanstvo, uskličnik je tu potpuno na mjestu. Rekao bih da je to jedan od rijetkih slučajeva gdje je uskličnik zaista opravdan!
Moj problem s tom objavom bio je više vezan uz zamjenicu “mi.” Tko je to “mi”? U kojoj mjeri možemo govoriti o AI zajednici ili istraživačkoj zajednici kao o jedinstvenoj cjelini? A što se tiče “više od 10%” — to je izmišljena brojka koja ne znači ništa. I u tehnološkoj industriji i drugdje postoji ta navika bacanja postotaka u zrak koji nisu utemeljeni ni na kakvim izračunima. [Naknadno sam shvatio da se tweet vjerojatno referira na koncept P(doom), ali i dalje mislim da je to besmisleno.]
Jedno što moram reći o Coxonovoj odluci jest — na Equityju se stalno vraćamo na istu temu: kad netko poput Sama Altmana ili Daria Amodeia priča o propasti, uvijek se nameće pitanje: Pa zašto onda nastavljaš s tim? Ako doista vjeruješ da bi AI mogao uništiti čovječanstvo, ne bi nastavio raditi na tome.
A ovdje imamo nekoga tko je zaista stavio novac tamo gdje mu je usta — rekao je “Vjerujem da je ovo stvarno, stvarno, stvarno loše i ne želim nastaviti raditi na tome” i otišao. Svaka mu čast na toj hrabrosti, makar ni za što drugo.
Kirsten Korosec: Da, njega bih svrstala u posebnu kategoriju, odvojenu od svih ostalih koji govore o opasnostima.
Sad ću staviti šešir spekulacija, jer vas obojicu želim nešto pitati: je li moguće da svaki put kad vidimo sve veći broj blog objava o još jednom incidentu u kojem neki AI agent nenamjerno probije granice, ili kad se govori o opasnosti po čovječanstvo — je li to zapravo čudan način hvalisanja naprednim sposobnostima njihovih modela?
Zvuči cinično, ali postiže upravo taj učinak. Jer da ti AI modeli nisu napredni, sposobni i ne probijaju granice — ne bismo morali brinuti o tim stvarima, zar ne? To je nekako jako čudan način da se pohvališ sposobnostima modela koje si razvio u svojoj kompaniji.
Anthony: I sam sam se to pitao. Ne mislim da je to potpuno cinično, u smislu da ne vjerujem da je sve to svjesna marketinška strategija. Mislim da mnogi od tih ljudi — bilo istraživači ili izvršni direktori — imaju iskrenu zabrinutost.
Ali naravno, to se u mnogo čemu poklapa s poslovnim interesima — reći “Wow, izgradili smo najsmrtonosniji softver koji je ikad napravljen.” Ne želim previše psihoanalizirati, ali drugi su već primijetili da postoji ta osobna napast: naravno da želiš vjerovati da je stvar na kojoj radiš najvažnija i najopasnija na svijetu.
Sean: Ono što mi se stalno vraća u glavi kad razmišljam o tom pitanju jest da postoji taj element koji kao da govori: “Radimo nešto toliko moćno, i to nam na neki način ide u prilog, čak i kad izgleda loše na razne načine.”
Ono što je drugačije kod nekih od ovih najnovijih primjera jest da stvarno stječeš dojam da te kompanije u određenim aspektima nemaju kontrolu nad tim stvarima — posebno kad je OpenAI u pitanju.
Sve više izvještaja govori o internim agentima koji pristupaju raznim wikijima na webu i ostavljaju jedni drugima poruke — i to na način koji ne ostavlja dojam da OpenAI s tim kompetentno upravlja. Pretpostavljam da bi priča bila malo uglađenija da je sve to isključivo osmišljeno kako bi ljude uvjerili da su napravili nešto nevjerojatno moćno.
Druga stvar koja mi je posebno zanimljiva jest da smo, što, nekoliko tjedana od Anthropicovog S-1 prospekta za IPO, a možda još koji tjedan ili dva od samog izlaska na burzu.
I pomisao da ćeš izaći s ovakvim izjavama, ovako jasnim rječnikom, uoči IPO-a — jako me zanima što to znači za cijeli taj proces. Koliko je ovakvih stvari već bilo upisano u S-1 i u odjeljak o rizicima? Postoje li mladi odvjetnici koji upravo sada prolaze kroz cijeli taj odjeljak i moraju ga prepisati da stoji: “Anthropicov je službeni stav da postoji više od 10% vjerojatnosti da bismo mogli razviti nešto što bi istrijebilo cijelo čovječanstvo, što bi materijalno štetilo našem poslovanju”?
Kirsten: Pretpostavljaš da to već nije tamo.
Sean: Upravo to i govorim: je li to već tamo i samo se preformulira? Ili je ovo pravi kaos? Mora da je već bilo nekakvog jezika o tome. Jedan od razloga zašto jedva čekam pročitati taj dokument — na načine koji u nekim aspektima idu čak i dalje od SpaceX S-1 prospekta — jest što sam siguran da će biti specifičnih stvari vezanih uz ove ideje koje će biti zanimljivo vidjeti.
Kirsten: Evo što mislim: u normalnom investicijskom okruženju, ovakav jezik bi mogao narušiti valuaciju kompanije jer odjednom zvuči opasno. Ali ne živimo u normalnim vremenima.
I opet se vraćam na svoju točku — moglo bi se pokazati da je to zapravo čudan, ali koristan adut za kompaniju na strani valuacije. Nije isto kao onaj trend provociranja radi reakcija koji smo vidjeli prošle godine, ali je u istom, recimo, svemiru — u kojemu snaga, sposobnost, pa čak i elementi opasnosti nečega, jednako visoka valuacija. Pretpostavljam da ćemo za nekoliko tjedana vidjeti.
Ako to na trenutak ostavimo po strani — što se poduzima po tom pitanju? Možemo li uopće kontrolirati ovo? Connor Leahy, izvršni direktor za SAD u neprofitnoj organizaciji ControlAI, bio je gost emisije ovog tjedna i govorio je upravo o tome. Dakle, što pratite kad je u pitanju kontrola opasnih aspekata AI-ja — ili samo dižemo ruke i gledamo kako se sve odvija?
Anthony: Ni sam nemam neki sjajan odgovor na to, ali razmišljao sam o nekim aspektima ove rasprave i možda o tome zašto reagiram onako kako reagiram.
Slažem se s jednom Seanovom točkom — mislim da dio svega ovoga govori o tome u kojoj mjeri te velike AI kompanije osjećaju da više nemaju kontrolu nad tim modelima. To definitivno nije dobro i to je nešto što bi trebalo zabrinjavati sve nas.
Mislim da sam dijelom skeptičan prema narativu o propasti — ili mu se opirem — jer dostiže razinu histerije: “Wow, ovo bi moglo uništiti čovječanstvo za 10 godina.” To je pomalo odvlačenje pažnje od neposrednijih šteta koje AI može uzrokovati — bilo onih vezanih uz tržište rada, bilo uz okoliš i klimu.
U idealnom slučaju, trebali bismo moći razgovarati o svemu tome i imati regulatorne i druge zaštitne mehanizme za sve te stvari, uključujući i egzistencijalnu prijetnju od AI-ja. Ali čim počneš koristiti pojmove poput AGI i superinteligencije, to jednostavno posrče sav kisik iz prostorije na način koji nije nimalo koristan.
Izvor: TechCrunch
Povezani članci
 Izvršni direktor Anthropica iznosi plan za ‘praćenje granice’12.9.2026.
 Nscale dodaje bivšu direktoricu OpenAI-a Fidji Simo u svoj odbor uoči mogućeg IPO-a11.9.2026.
 Anthropic otkriva da odmetničke AI agente mrze CAPTCHA-e, baš kao i vi10.9.2026.
 DOJ želi više odgovora o Foxovom dogovoru s Rokuom vrijednom 22 milijarde dolara9.9.2026.


