



Sep 13, 2026
Tim AllSpark objavio je Iris-mini i Iris-pro – dva open-source agenta za pretraživanje weba zajedno s potpunim opisom postupka treniranja. Prema istraživačkom radu, podaci za treniranje i sami modeli poboljšali su rezultate i na zadacima za koje nisu bili trenirani, uključujući opće korištenje alata i uredski rad.
Agenti za pretraživanje temeljeni na jezičnim modelima samostalno istražuju web. Moraju razumjeti postavljeno pitanje, odlučiti što će tražiti, interpretirati rezultate i procijeniti kada su prikupili dovoljno dokaza za odgovor. Koliko toga modeli zapravo i rade, predmet je rasprave. Na etabliranim mjerilima, vodeći AI sustavi ove vrste uglavnom koriste web kako bi potvrdili znanje koje su već usvojili tijekom treniranja.
U novom istraživačkom radu, kineski laboratorij AllSpark opisuje dva agenta za pretraživanje različitih veličina. Iris-mini ima 35 milijardi parametara, a Iris-pro 397 milijardi. Oba se temelje na modelima iz serije Qwen (Qwen3.6-35B-A3B i Qwen3.5-397B-A17B), rade s kontekstnim prozorom od 256.000 tokena te, prema tvrdnjama tima, postižu najbolje rezultate među open-weight agentima za pretraživanje u svojoj klasi veličine.
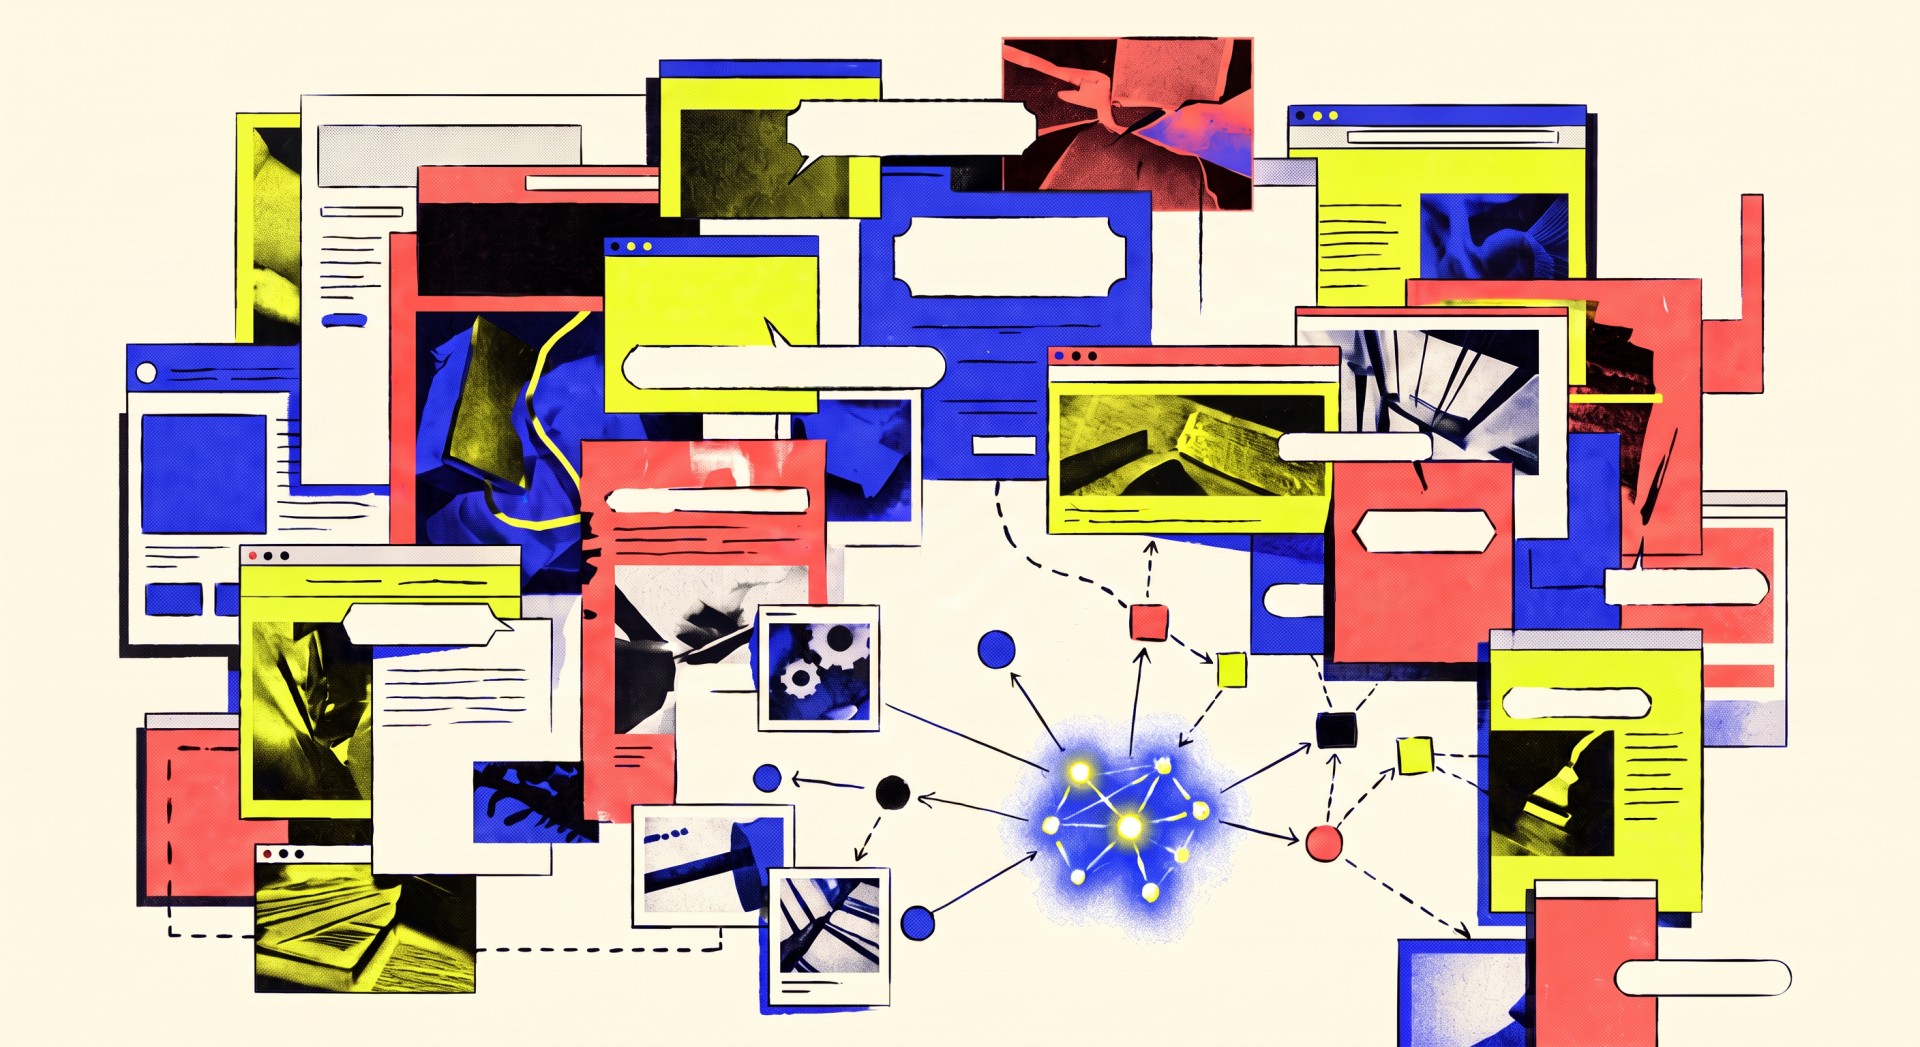
Pitanja za treniranje izvode se unatrag iz strukture poveznica na webu
Cjevovod za treniranje gradi zadatke unatrag, polazeći od strukture poveznica na web-stranicama. Krenuvši od početne stranice i njezinih odlaznih poveznica, sustav konstruira graf pojmova i odnosa. Iz tog grafa zatim generira višekoračno pitanje čiji odgovor zahtijeva ulančavanje nekoliko međusobno povezanih koraka.
Svaki pojam osim konačnog odgovora zamjenjuje se parafrazom, tako da se nijedan trag ne može razriješiti jednostavnim pretraživanjem teksta. Agent mora zaključivati, a ne samo tražiti informacije. U skup podataka ulaze samo ona pitanja koja referentni model ne može riješiti bez alata, ali može uz odgovarajuće izvore. Time se zadaci održavaju istovremeno zahtjevnima i jasno provjerljivima.
Dvostupanjsko filtriranje uklanja loše podatke za treniranje
Snažniji model-učitelj generira putanje rješenja sastavljene od zaključivanja, upita za pretraživanje i rezultata. Te putanje prolaze kroz dvije runde filtriranja. Prva provjerava cjelokupnu putanju s obzirom na ispravnost, petlje ponavljanja i dubinu pretraživanja. Druga je korak-po-korak pregled koji provodi model-sudac čiji su kriteriji izvedeni iz samih podataka, a ne postavljeni ručno, kako se navodi u radu.
Nakon toga model se unapređuje pojačanim učenjem uz pretraživanje živog weba. Model-sudac i sažeci rezultata izvode se unutar klastera za treniranje, pogonjeni timovim vlastitim velikim Qwen modelom, tako da treniranje ne ovisi o vanjskim uslugama. Nadzirano fino podešavanje i pojačano učenje izmjenjuju se u procesu koji autori nazivaju „SFT-RL penjanjem”. Najteži riješeni zadaci i najefikasnije putanje rješenja iz svake runde vraćaju se u sljedeći ciklus treniranja.
Upravljanje kontekstom možda je važnije od razlika između modela
Tim tvrdi da upravljanje kontekstom u stvarnom vremenu na uobičajenim mjerilima često čini veću razliku nego prijavljeni razmaci između sustava. Tijekom dugih istraživačkih sesija kontekst se može popuniti prije nego što agent razriješi sva podpitanja. Trikovi poput odbacivanja povijesti razgovora umjetno produžuju istraživanje, ali malo govore o stvarnoj kvaliteti modela.
Kako bi izolirali taj učinak, tim testira svako mjerilo sa i bez upravljanja kontekstom, uz nepromijenjene alate, ograničenja konteksta i model-suca. Rezultati koji se prijavljuju isključivo uz uključeno upravljanje ne mogu se jasno razdvojiti na ono što dolazi od samog modela i ono što dolazi od infrastrukture oko njega. Iris rezultati također potječu od jednog agenta, bez pomoćnih agenata i bez dodatnih koraka provjere na kraju.
Rezultati na četiri mjerila
Testiranje je obuhvatilo BrowseComp, koji ispituje sposobnost pronalaženja rijetkih činjenica iz neizravnih tragova, njegov kineski pandan BrowseComp-ZH, DeepSearchQA, koji ocjenjuje potpunost pronađenih dokaza, te Humanity’s Last Exam, koji postavlja akademska pitanja na razini stručnjaka.
Uz uključeno upravljanje kontekstom, Iris-mini postiže 82,2, 84,8, 86,9 i 52,3 boda prema radu. Iris-pro dostiže 88,6, 85,1, 92,9 i 56,4. U manjoj klasi, Iris-mini vodi na tri od četiri mjerila i nadmašuje sljedeći najbolji model, XYZ-Aquila-mini, na BrowseCompu za 3,4 boda, iako zaostaje na DeepSearchQA. Iris-pro vodi ili izjednačuje u većoj klasi i ponekad se približava sustavima koji zahtijevaju daleko više računalne snage, navode autori.

Upravljanje kontekstom ima znatno veći učinak na manji model, podižući BrowseComp rezultate za čak 21,2 boda. Razlog nije manji budžet tokena, već brža potrošnja, kako se navodi u radu. Iris-mini treba više koraka za iste zadatke i češće dostiže granicu konteksta.
Na Humanity’s Last Exam dobici su manji jer se to mjerilo više oslanja na domensko znanje i akademsko zaključivanje, gdje pretraživanje weba ima sporednu ulogu. Najbolji rezultati postižu se kombinacijom odbacivanja povijesti i drugog pokušaja. Ako prvi pokušaj ne uspije, sustav ga sažima u kratku bilješku koja bilježi što je već provjereno i isključeno. Ta se bilješka dodaje zadatku za sljedeći pokušaj.
Kada je točan odgovor pogrešan
U dodatku rada tim opisuje slučaj u kojemu je njihov agent označen kao netočan, iako je odgovor bio potkrijepljen izvornim materijalom. Pitanje u BrowseComp-ZH odnosilo se na seriju „Igra prijestolja”. Agent je odgovorio „Bolton”, ali točan odgovor prema mjerilu glasio je „Lannister”. Lik o kojemu je riječ, Sansa Stark, u svom drugom braku zapravo se udaje za Ramsaya Boltona. Agentov odgovor bio je ispravan. Tim navodi da ih ovakve proturječnosti između zadanih odgovora i izvornog materijala motiviraju da razvijaju bolja mjerila.

Osim pretraživanja, autori bilježe i neočekivani nusprodukt. I generirani podaci za treniranje i specijalizirani modeli poboljšali su rezultate na zadacima za koje nisu bili trenirani, uključujući opće korištenje alata i uredski rad. Tim pretpostavlja da pretraživanje možda funkcionira više kao temeljna vještina nego kao uska specijalnost, budući da naučeno ponašanje pomaže svugdje gdje agent mora raditi s nepotpunim informacijama.
Težine modela za Iris-mini i Iris-pro dostupne su u kolekciji na Hugging Faceu, a kod je objavljen na GitHubu. Objava za sada uključuje Iris Harness s petljom agenta, alatima, strategijama upravljanja kontekstom i sva četiri mjerila s evaluacijom. Harness radi s bilo kojim OpenAI-kompatibilnim krajnjim točkama. Tim planira kasnije objaviti i cjevovode za izgradnju podataka i treniranje.
Pročitajte cijeli članak.
Pretplatite se za izvještavanje bez hype-a.
- Potpuni pristup svim člancima na THE DECODER
- Bez reklama
- Sudjelujte u komentarima i raspravama zajednice
- Tjedni pregled AI vijesti putem e-pošte
- 6x godišnje: „AI Radar” – dubinske analize najvažnijih AI tema
- Dnevne AI vijesti, uvijek ažurne
- Pristup našem desetogodišnjem arhivu
- Tim s više od 10 godina iskustva u AI-ju
Pretplatite se na The Decoder
Izvor: The Decoder
Povezani članci
 Izvršni direktor Anthropica Amodei želi ograničenja brzine razvoja umjetne inteligencije prije nego što samounapređivanje nadmaši ljudsku kontrolu13.9.2026.
 Bivši potpredsjednik Deepminda Vinyals kaže da samo-poboljšanje AI-a dolazi, ali neće pokrenuti eksploziju inteligencije12.9.2026.
 Swarmchaseri love odmetnutih agenata, Anthropic istražuje sam sebe, a trag koji oboje slijede nestaje u mraku.11.9.2026.
 Suno lansira v6 glazbene modele izgrađene s Warnerom, BMG-om i Believeom10.9.2026.


