Oct 11, 2026
Istraživanje pokazuje da timovi AI agenata gotovo uopće ne postižu bolje rezultate od pojedinačnih agenata.
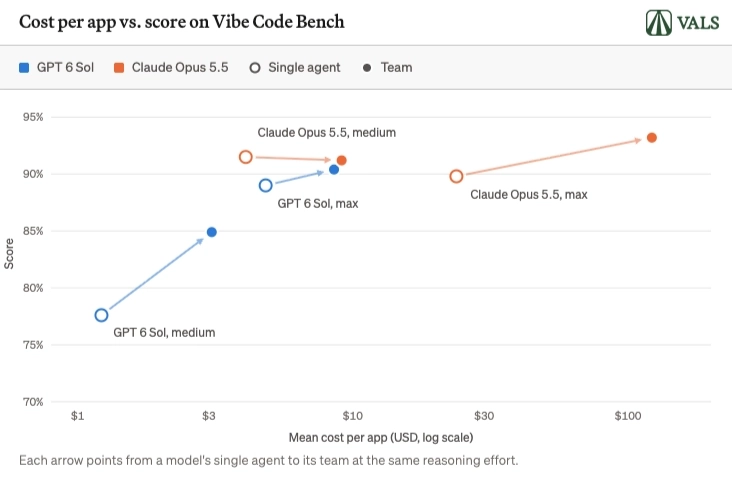
Tvrtka za evaluaciju Vals AI testirala je GPT-6 Sol i Claude Opus 5.5 na benchmarku „Vibe Code Bench” – i pojedinačno i u timovima – na dvije razine zaključivanja: srednjoj i maksimalnoj. Timovi su koštali između 1,8 i 5,1 puta više od pojedinačnih agenata.
Od četiri usporedbe timova i pojedinačnih agenata, samo je jedna pokazala statistički značajno poboljšanje: GPT-6 Sol na srednjoj razini zaključivanja, gdje je tim ostvario 7,3 boda više. Na maksimalnoj razini zaključivanja, timska konfiguracija nije donijela nikakvu stvarnu prednost ni Solu ni Opusu 5.5. Rezultati upućuju na to da se dodatni trošak timova agenata u većini slučajeva ne isplati – posebno kada modeli već rade pri punom kapacitetu računanja.
Anthropic je u dva vlastita testa s Opusom 5.5 zabilježio sve manje dobitke u kvaliteti kako je dodavao više agenata. Veći timovi brže su dosezali određenu razinu performansi, ali povećanje s deset na 100 agenata nakon 24 sata rezultiralo je tek minimalnim porastom rezultata. U zasebnim ProgramBench testovima, ubrzanje je dolazilo po cijenu veće potrošnje tokena.
| Zadatak s Opusom 5.5 | 1 agent | 10 agenata | 30 agenata | 100 agenata |
|---|---|---|---|---|
| Baza znanja | 0,53 | 0,70 | 0,71 | 0,74 |
| Dokazivanje teorema (Lean) | 0,39 | 0,66 | 0,66 | 0,68 |
Fable 5.1 pokazao je izraženije dobitke u kvaliteti na zadatku dokazivanja Lean teorema iznad deset agenata, no ipak je na svim testovima zaostajao za Opusom 5.5. Na zadatku baze znanja, Fableov rezultat čak je blago pao pri skaliranju s 30 na 100 agenata.
Više agenata donosi brzinu, ali ne i bolju kvalitetu
Istraživač OpenAI-ja Noam Brown potvrdio je u podcastu Dwarkesh da višeagentni sustavi uglavnom kupuju brzinu, a ne bolju kvalitetu. Četiri agenta rješavala su zadatke dvostruko brže, ali su i koštala dvostruko više. Pri 16 agenata obrazac se zadržao, no učinkovitost je bila nešto niža.
Učinak uvelike ovisi o vrsti zadatka. Pretraživanje weba i matematika dobro se paraleliziraju, ali pisanje romana – ne, rekao je Brown. Baciti 10.000 agenata na pisanje romana jednako je besmisleno kao i angažirati 10.000 ljudi za isti posao. Brown je priznao da skaliranje na vrlo veliki broj agenata ostaje uglavnom neistraženo, jednostavno zato što su troškovi previsoki.
OpenAI-jev developer Eric Provencher nedavno je upozorio na opasnost od korištenja rojeva agenata upravo iz tog razloga. Najvjerojatnije je riječ o bacanju novca, tvrdi on, jer koordinacija između agenata puca po šavovima. Taj fenomen nazvao je „porezom na koordinaciju”.
Pročitajte cijeli članak.
Pretplatite se za izvještavanje bez hype-a.
- Puni pristup svim člancima na THE DECODER
- Bez oglasa
- Sudjelujte u komentarima i raspravama zajednice
- Tjedni pregled AI vijesti putem e-pošte
- 6x godišnje: „AI Radar” — dubinska analiza najvažnijih AI tema
- Dnevne AI vijesti, uvijek ažurne
- Pristup našem desetogodišnjem arhivu
- Tim s više od 10 godina iskustva u praćenju AI-ja
Pretplatite se na The Decoder
Izvor: The Decoder
Povezani članci
 OpenAI tvrdi da je neusklađeni model namjerno uništio vlastito okruženje u nadi da će dobiti novi početak s boljim podacima10.10.2026.
 Sigurnosna kriza OpenAI-a nastavlja se pogoršavati, a tvrtka je samo dodatno pogoršava9.10.2026.
 Jedan jedini upit bio je dovoljan za preuzimanje kontrole nad svakim AI agentom u AWS računu, otkrili su istraživači tvrtke Zenity8.10.2026.
 ChatGPT ocijenjen kao “neprihvatljiv rizik” za tinejdžere nakon što su roditeljska upozorenja zakazala tijekom razgovora o samoubojstvu7.10.2026.