


Nema sumnje – GPT-Image-2, model za generiranje slika koji je predstavljen u travnju, i dalje drži titulu kralja AI generiranja slika.
Svuda ga ima: od složenih infografika do jednostavnih obrada fotografija koje rade obični korisnici.
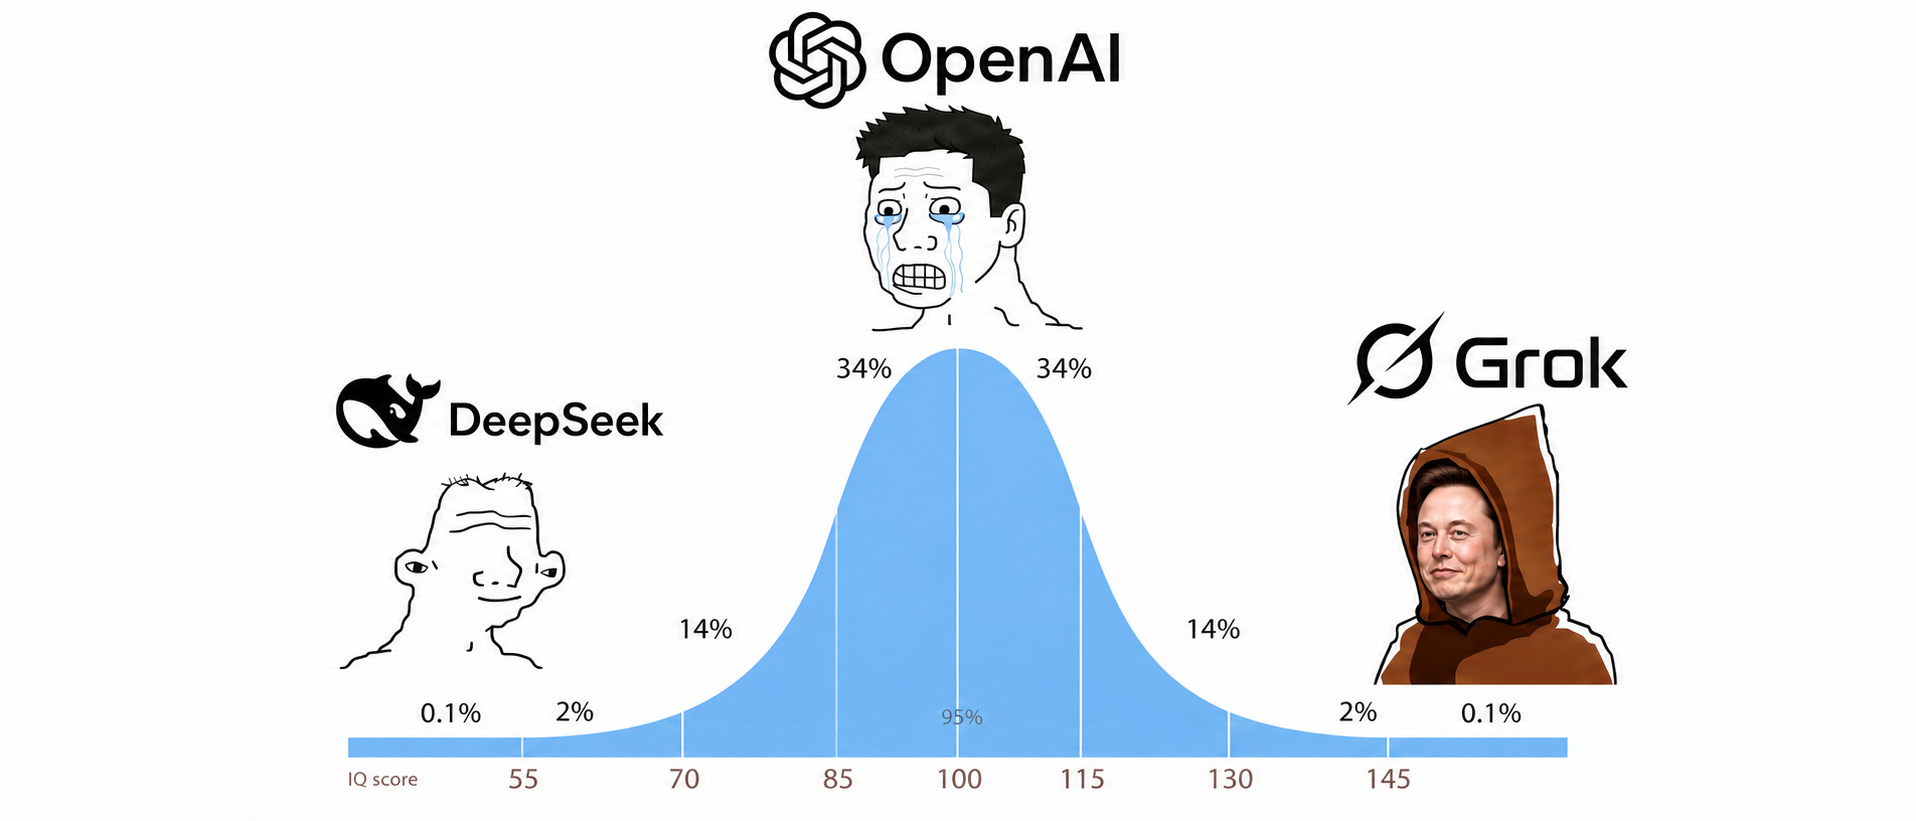
Modelima koji žele probiti se na to tržište sama kvaliteta više nije dovoljna. Ovih dana Imagine Image 2.0, koji Musk strastveno promovira na platformi X, privukao je veliku pozornost zahvaljujući mogućnosti izrade memova.
Na ljestvici velikih modela (LLM Arena), ovaj novi model za generiranje slika zauzima drugo mjesto u svijetu u obje kategorije – pretvaranje teksta u sliku i uređivanje slika.

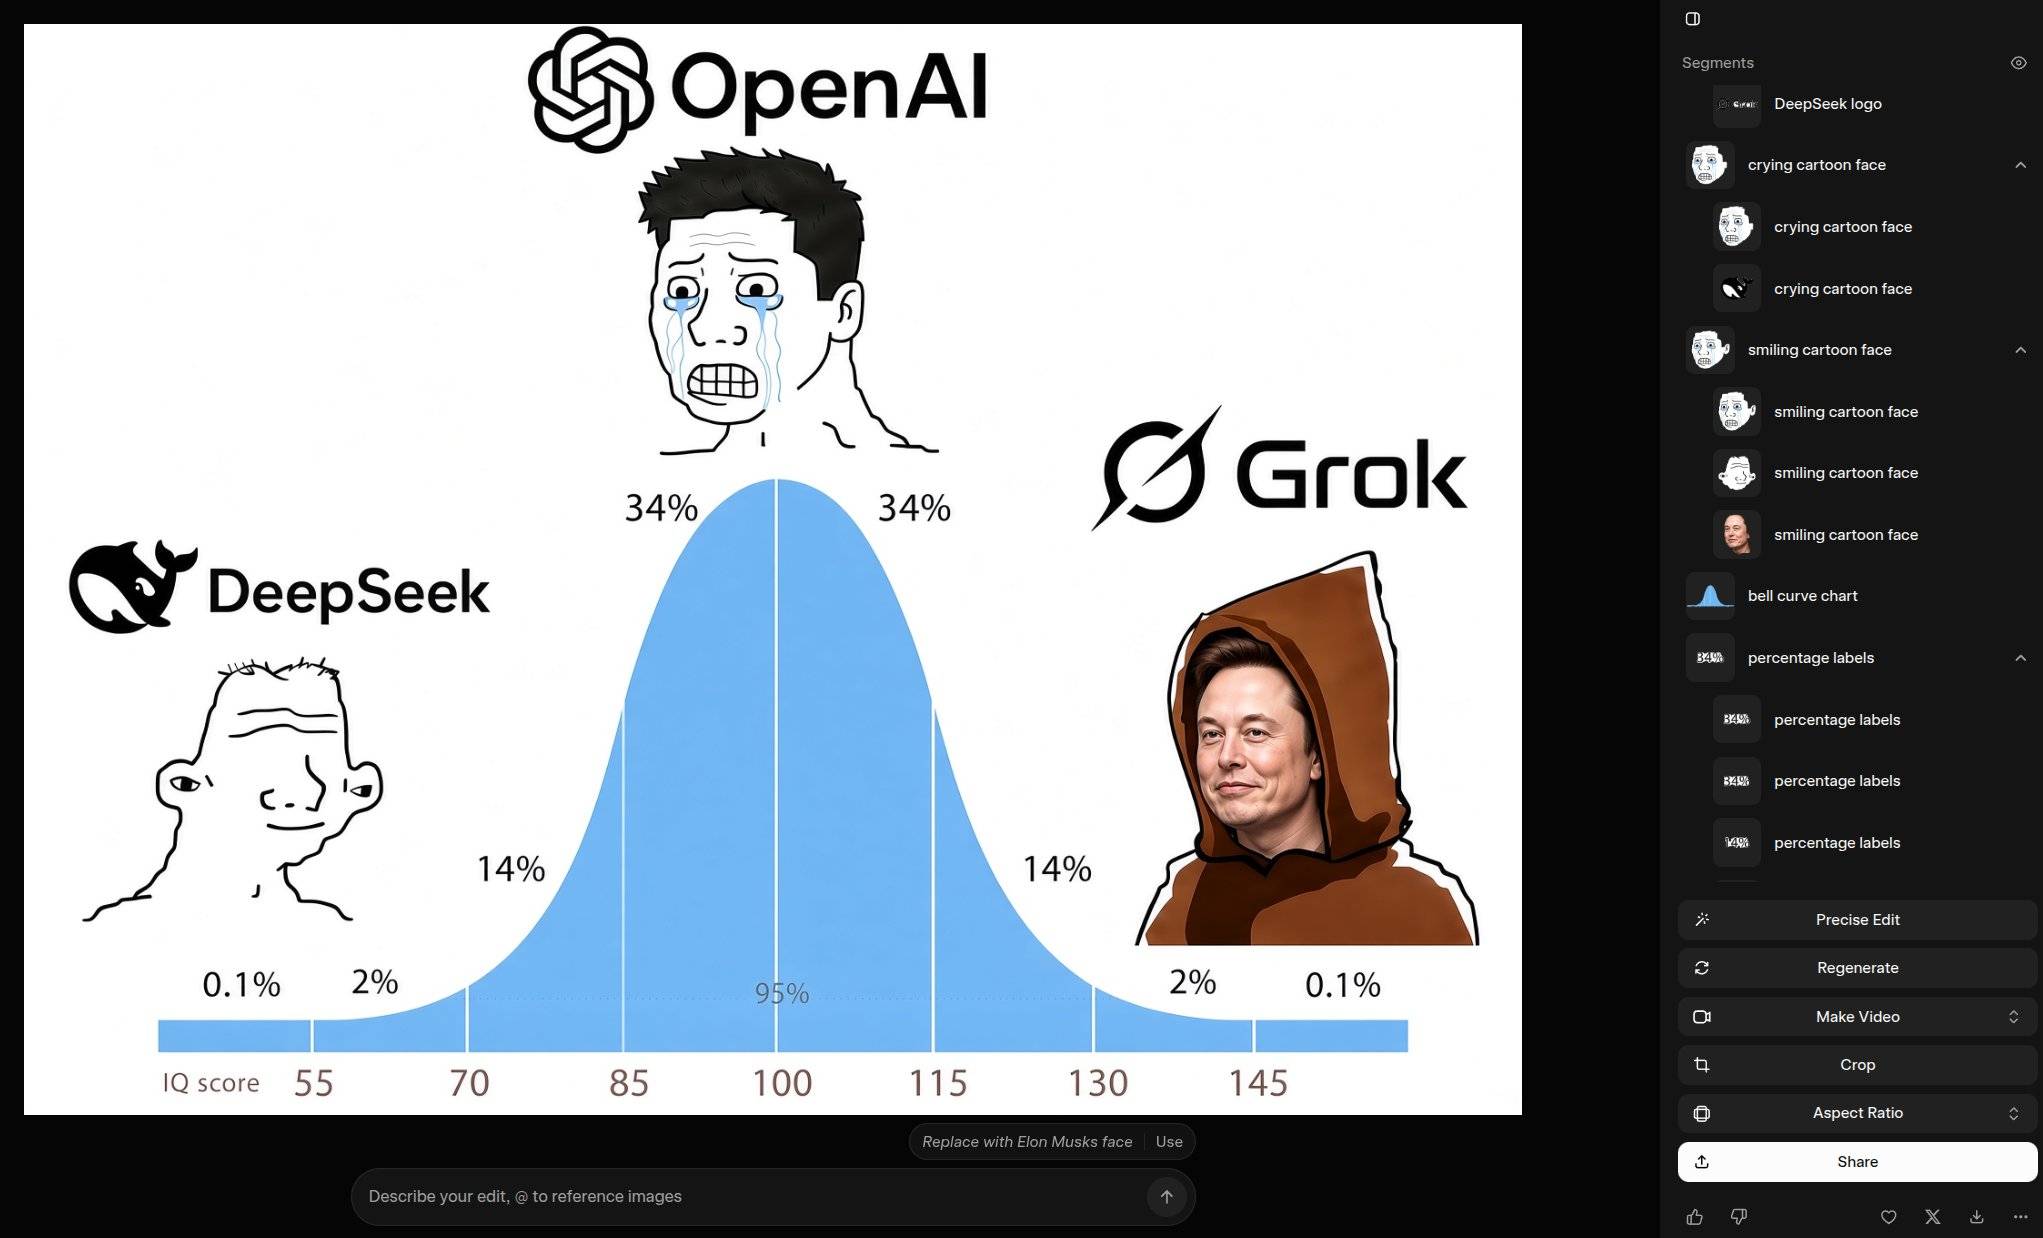
Osim uobičajenih primjena poput AI generiranja infografika s puno teksta, oglasa, materijala za igre, UI/UX prototipova i storyboarda, Imagine Image 2.0 ovaj put posebno naglašava interaktivno i precizno uređivanje slika.

Dovoljno je učitati fotografiju – Grok je automatski raslojavaju, a korisnik zatim može precizno odabrati određeno područje i izmijeniti ga.
Primjerice, na poznatom Wikipedija memu Grok je sliku rastavio na svaki komad razbijene Zemlje, a lik koji je drži podijelio je u dva zasebna sloja: samo lice i sloj s rukama i gestama.
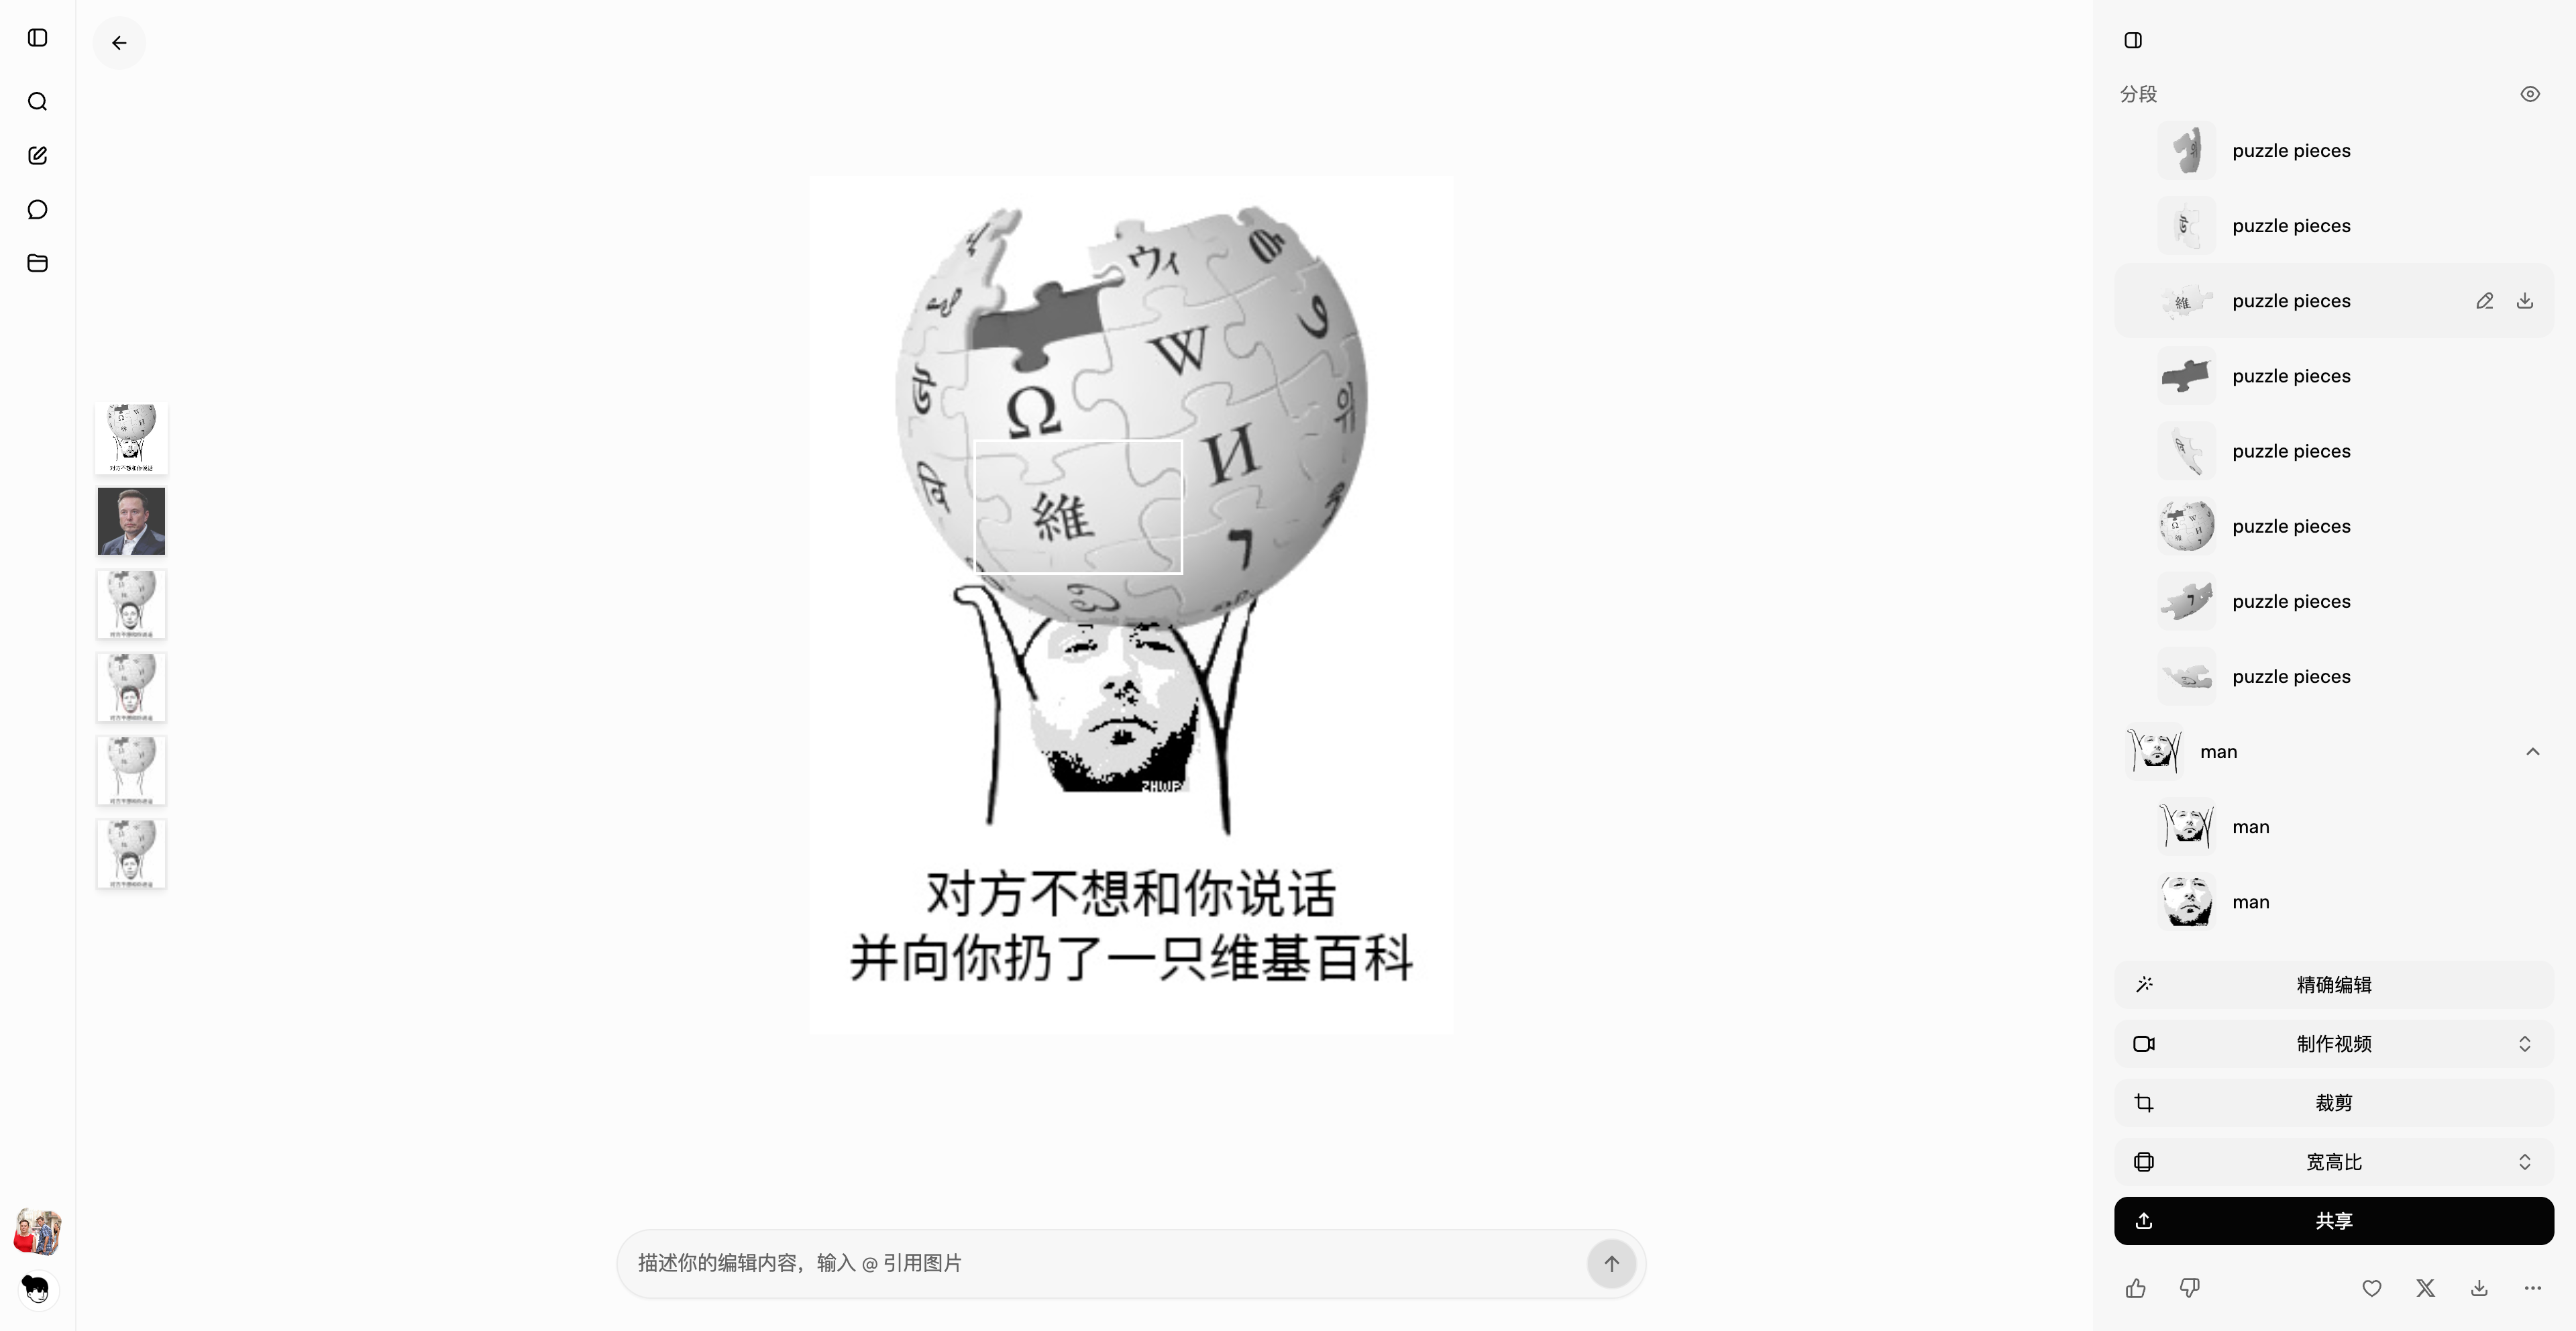
Klikom na gumb za preuzimanje pored pojedinog sloja, bilo koji objekt iz slike može se odmah izvesti s prozirnom pozadinom. Uz to, alat za magični odabir (magic wand) omogućuje ručno uređivanje područja koja automatsko raslojavanje nije pokrilo.
Imagine Image 2.0 podržava i spajanje više slika – funkcija višestrukih referenci odjednom može obraditi do 5 ulaznih fotografija i automatski ih spojiti u jednu.

Isprobajte sami: https://grok.com/imagine
Sve može postati mem
Otvorite Imagine stranicu, učitajte jednu ili više fotografija, kratko opišite što želite – i odmah ćete se naći na stranici za uređivanje slike.
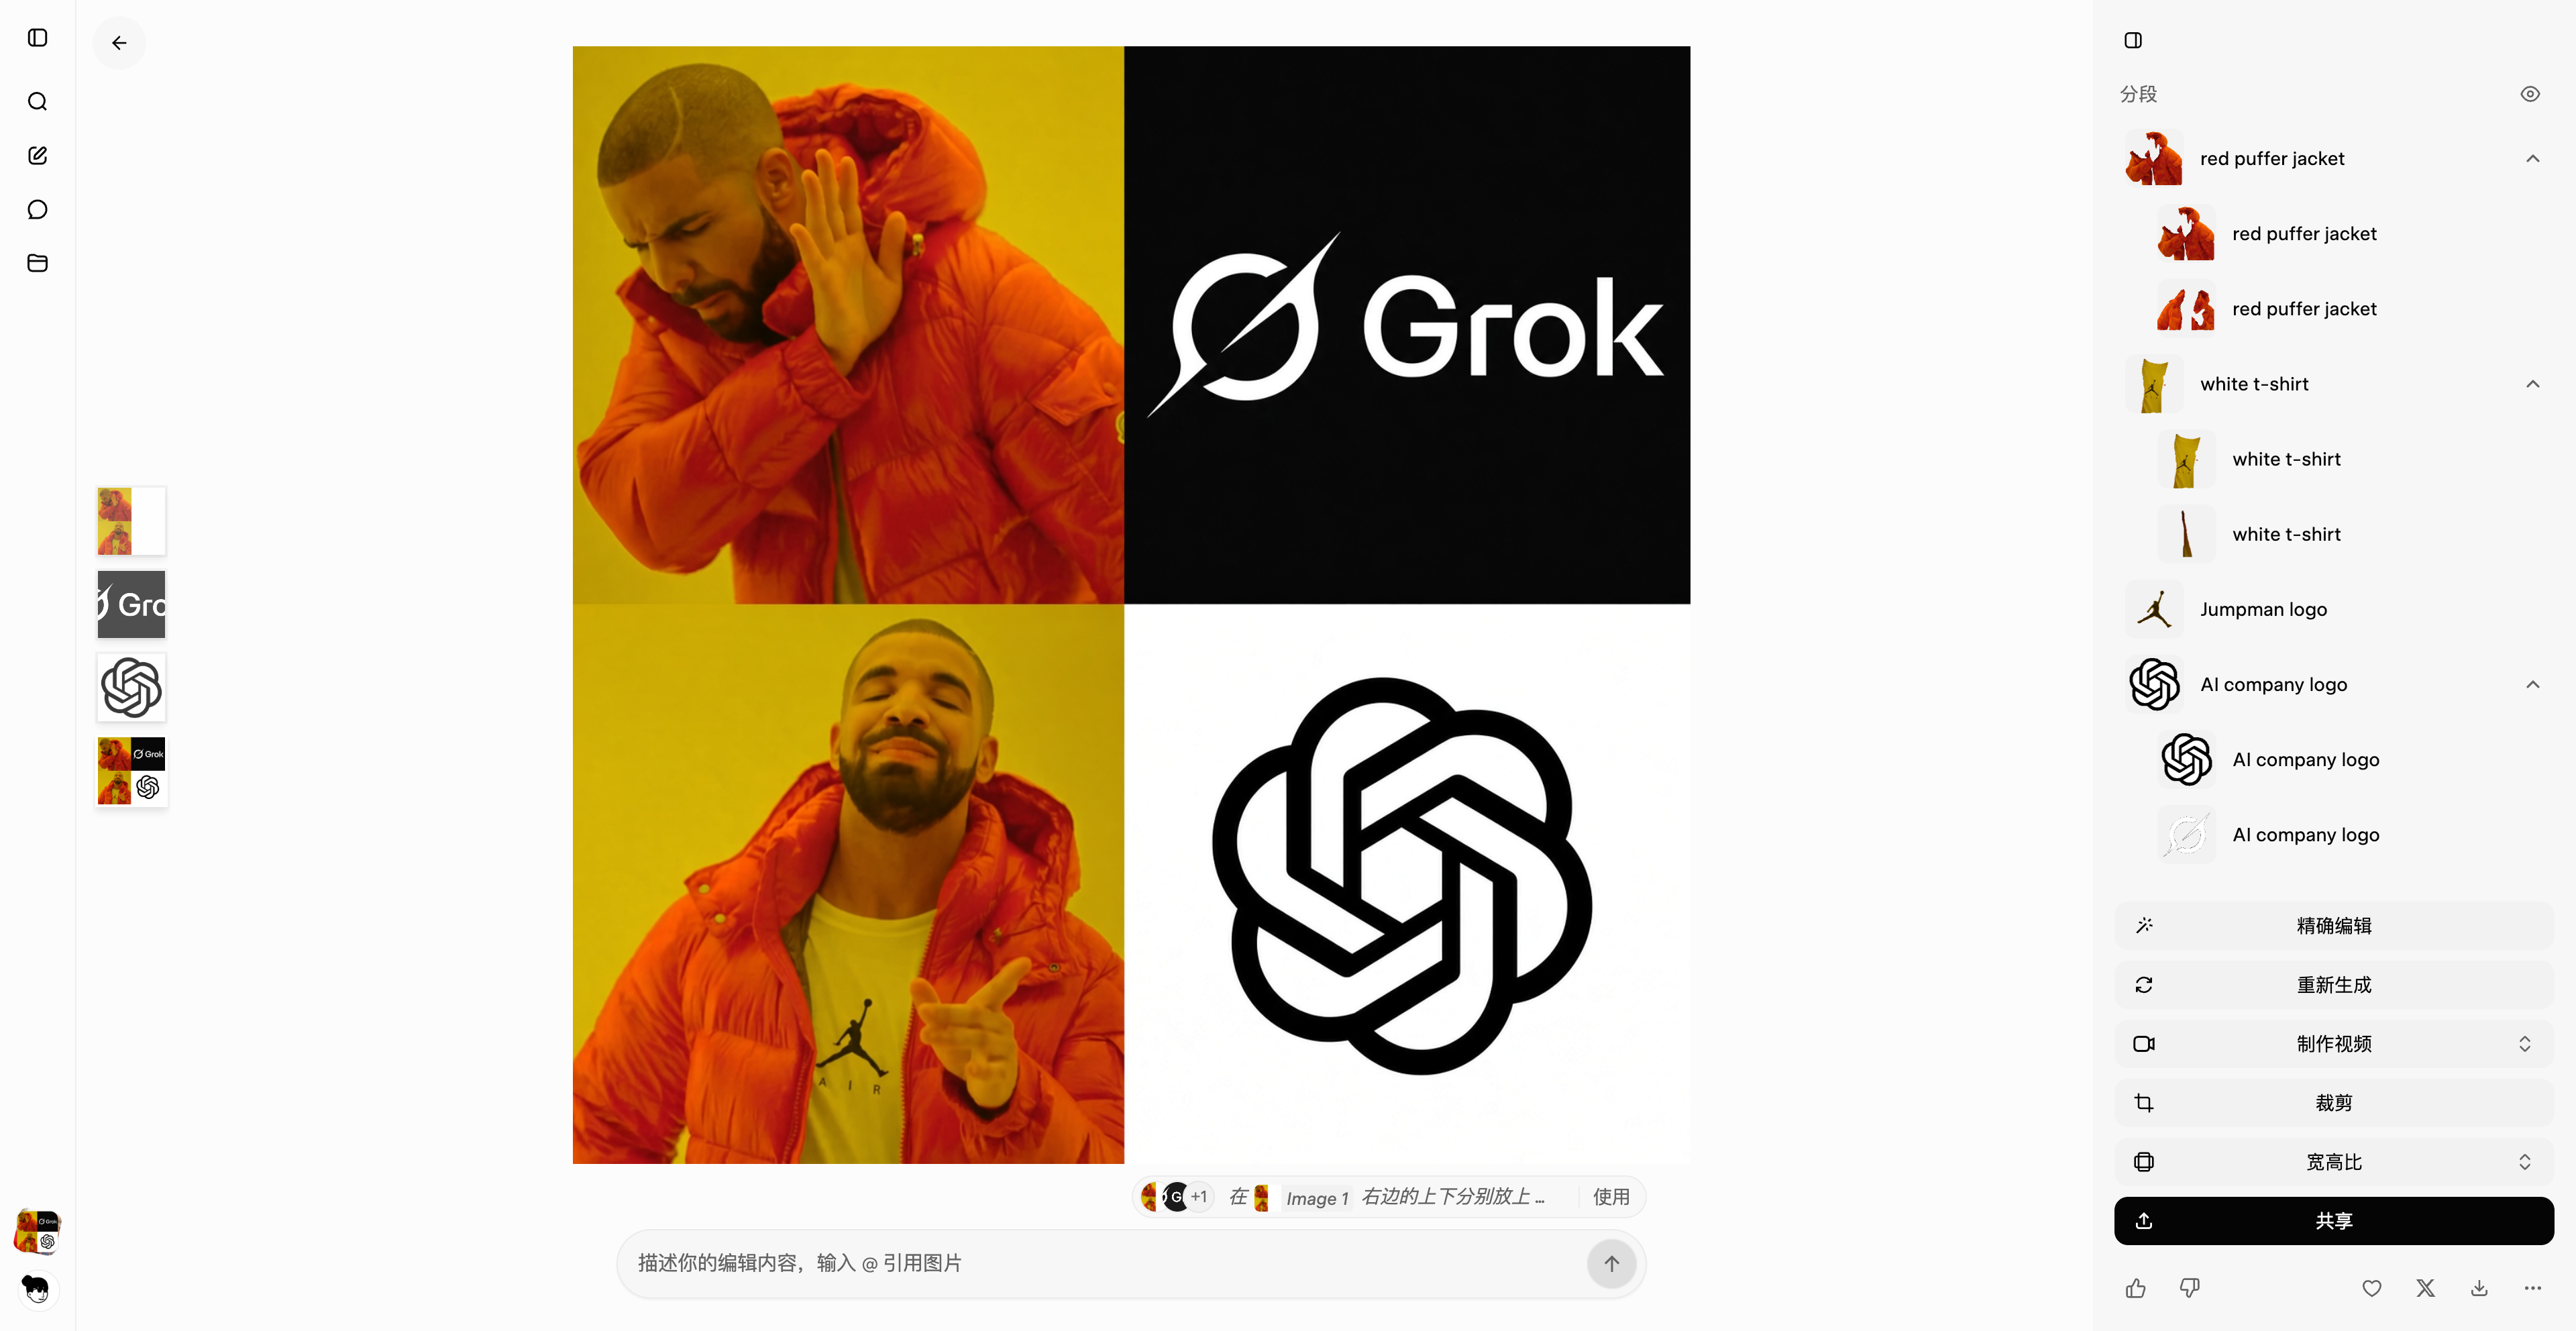
U desnoj bočnoj traci odozgo prema dolje prikazani su slojevi koje je Imagine Image 2 automatski prepoznao nakon uklanjanja pozadine – primjerice, na jednoj fotografiji slojevi su bili crvena jakna, bijela majica i logotipi AI tvrtki.
Svaki element može se izravno kliknuti i urediti, no u tom trenutku jedino što je dostupno jest unos tekstualnog upita – bez mogućnosti dodavanja referentnih slika. Zbog toga rezultat uvelike ovisi o tome koliko model dobro poznaje svijet.
Ispod toga nalazi se opcija preciznog uređivanja: ako automatsko prepoznavanje nije uhvatilo određeni element, korisnik ga može ručno označiti okvirom i dodati u odabir, ili ga izravno izmijeniti tekstualnim uputama.
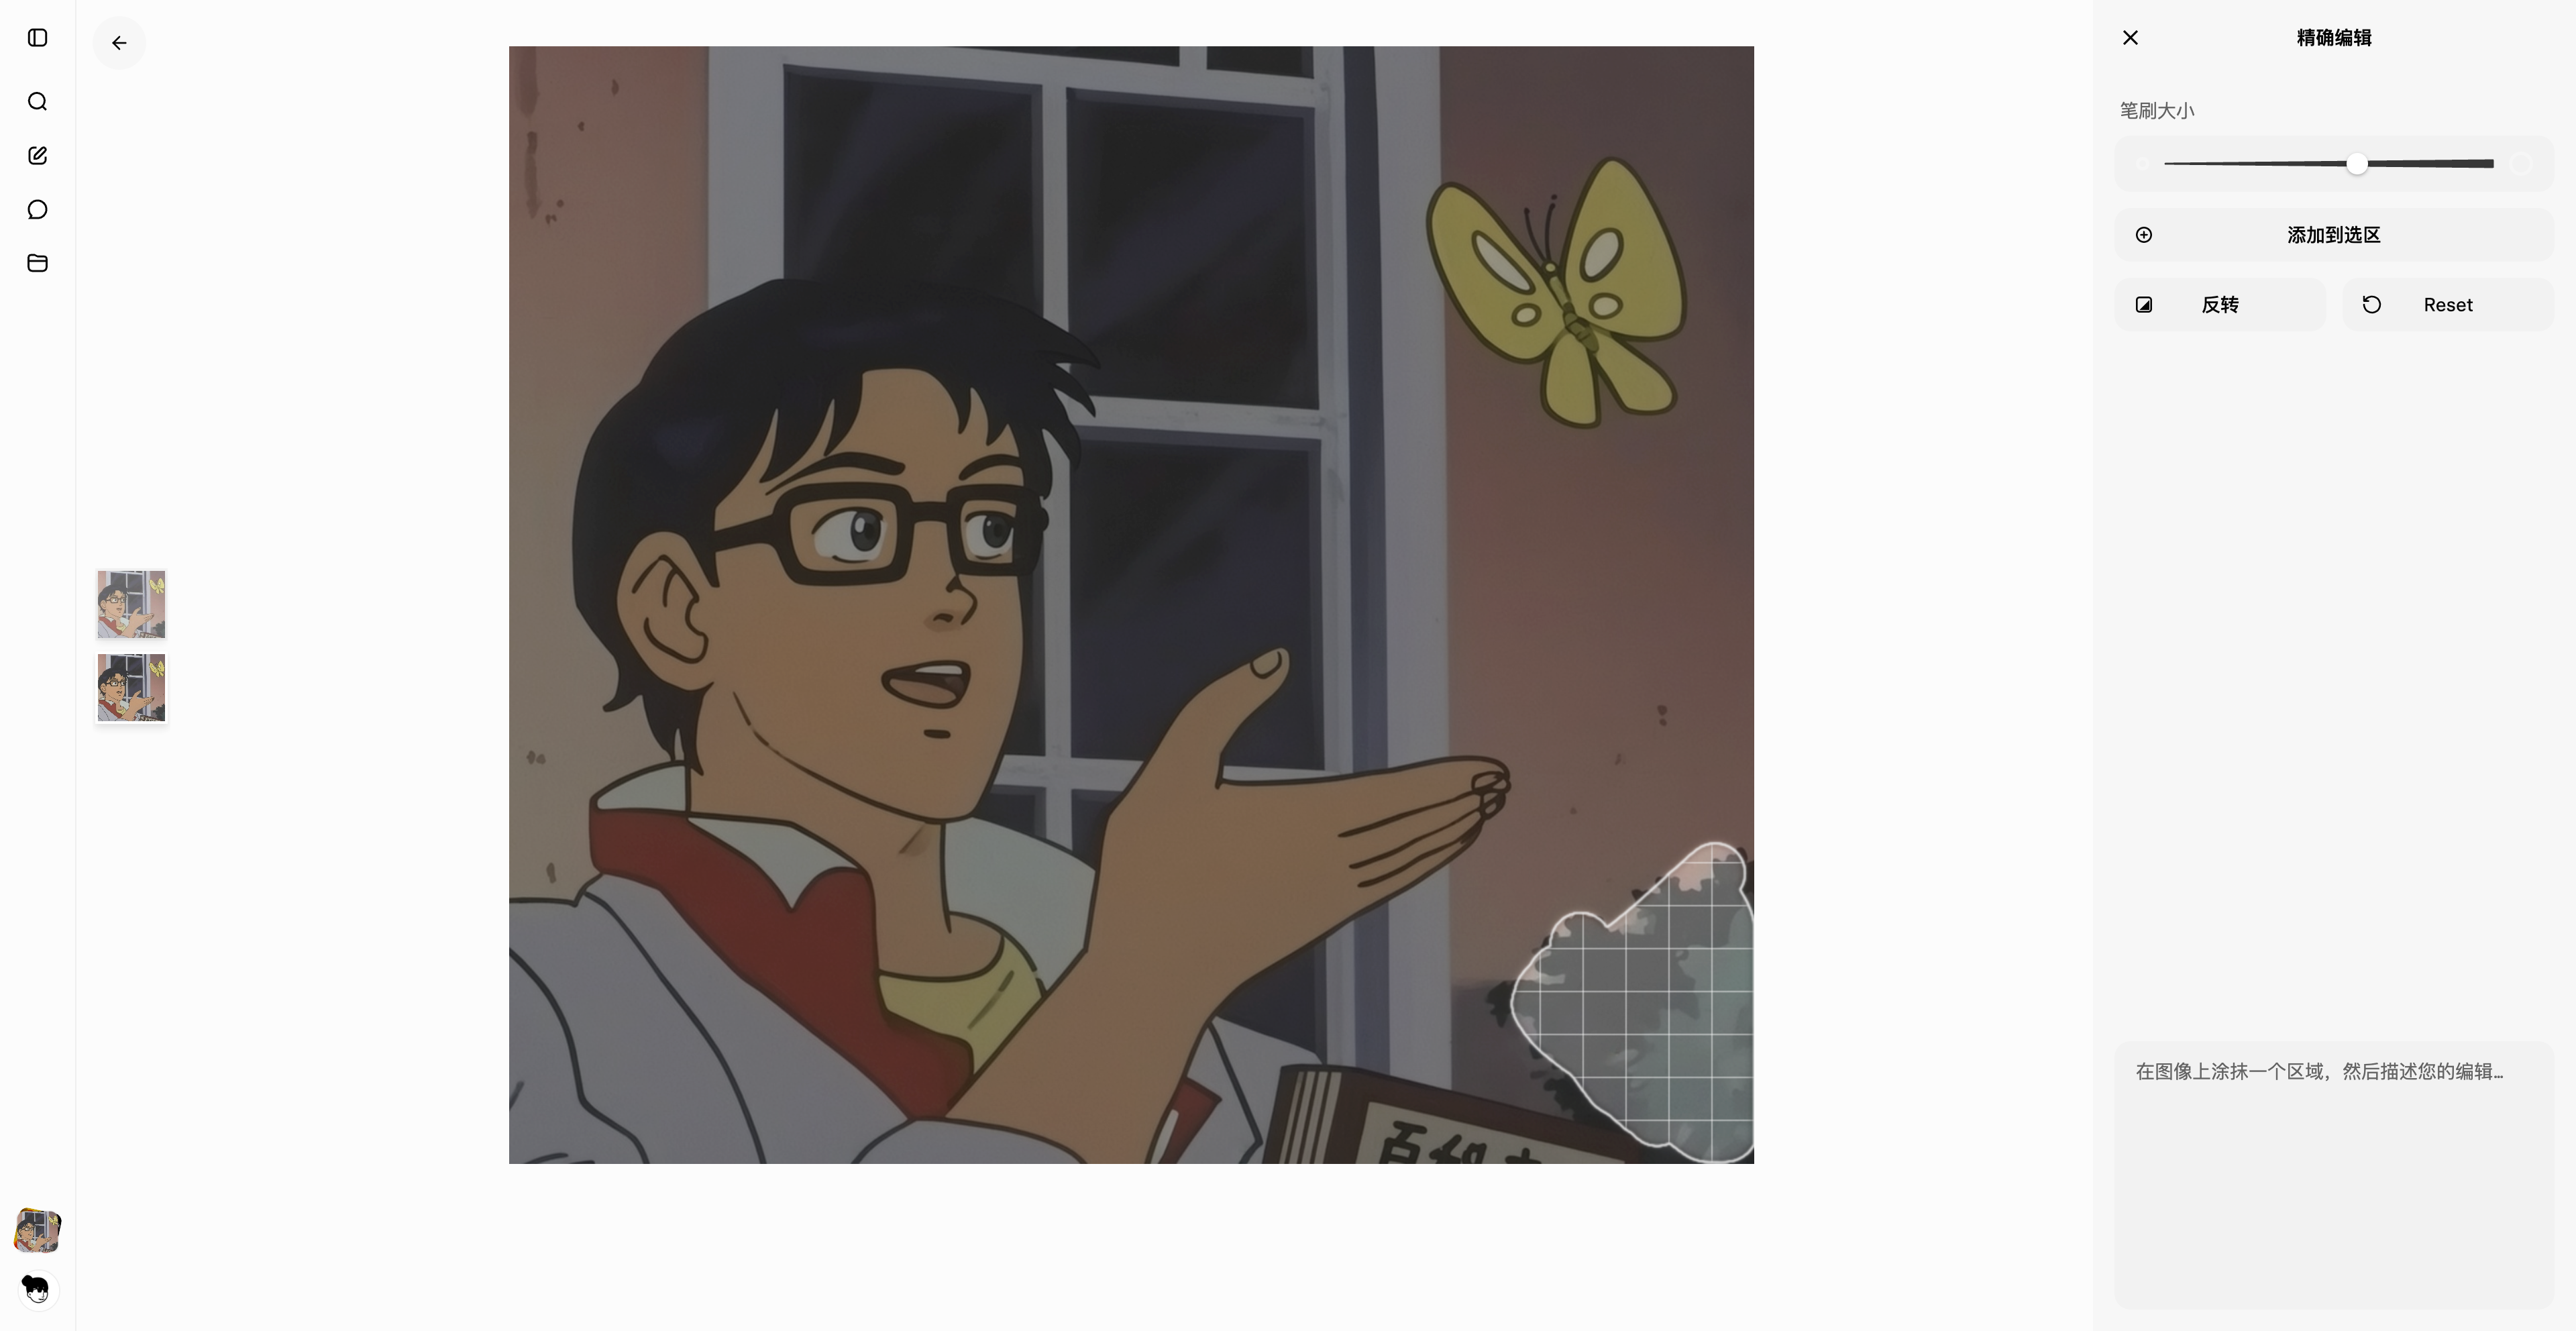
▲ Element se može izravno dodati u odabir
Sve te mogućnosti preciznog uređivanja omogućuju brzu prilagodbu postojećih memova za vlastite potrebe.
Uzmimo primjer klasičnog mema s rastresenim dečkom – svaki dio slike može se zasebno urediti, a sadržaj zamijeniti ili nadopuniti po želji.

Slično funkcionira i s memovima koji prikazuju bijelu ploču u sali za sastanke – svaki oblačić za dijalog automatski se prepoznaje kao zasebni odabir. Dovoljno je kliknuti na željeni oblačić i zatražiti da se ispuni tekstom, a rezultat je vertikalni strip u stilu mema.
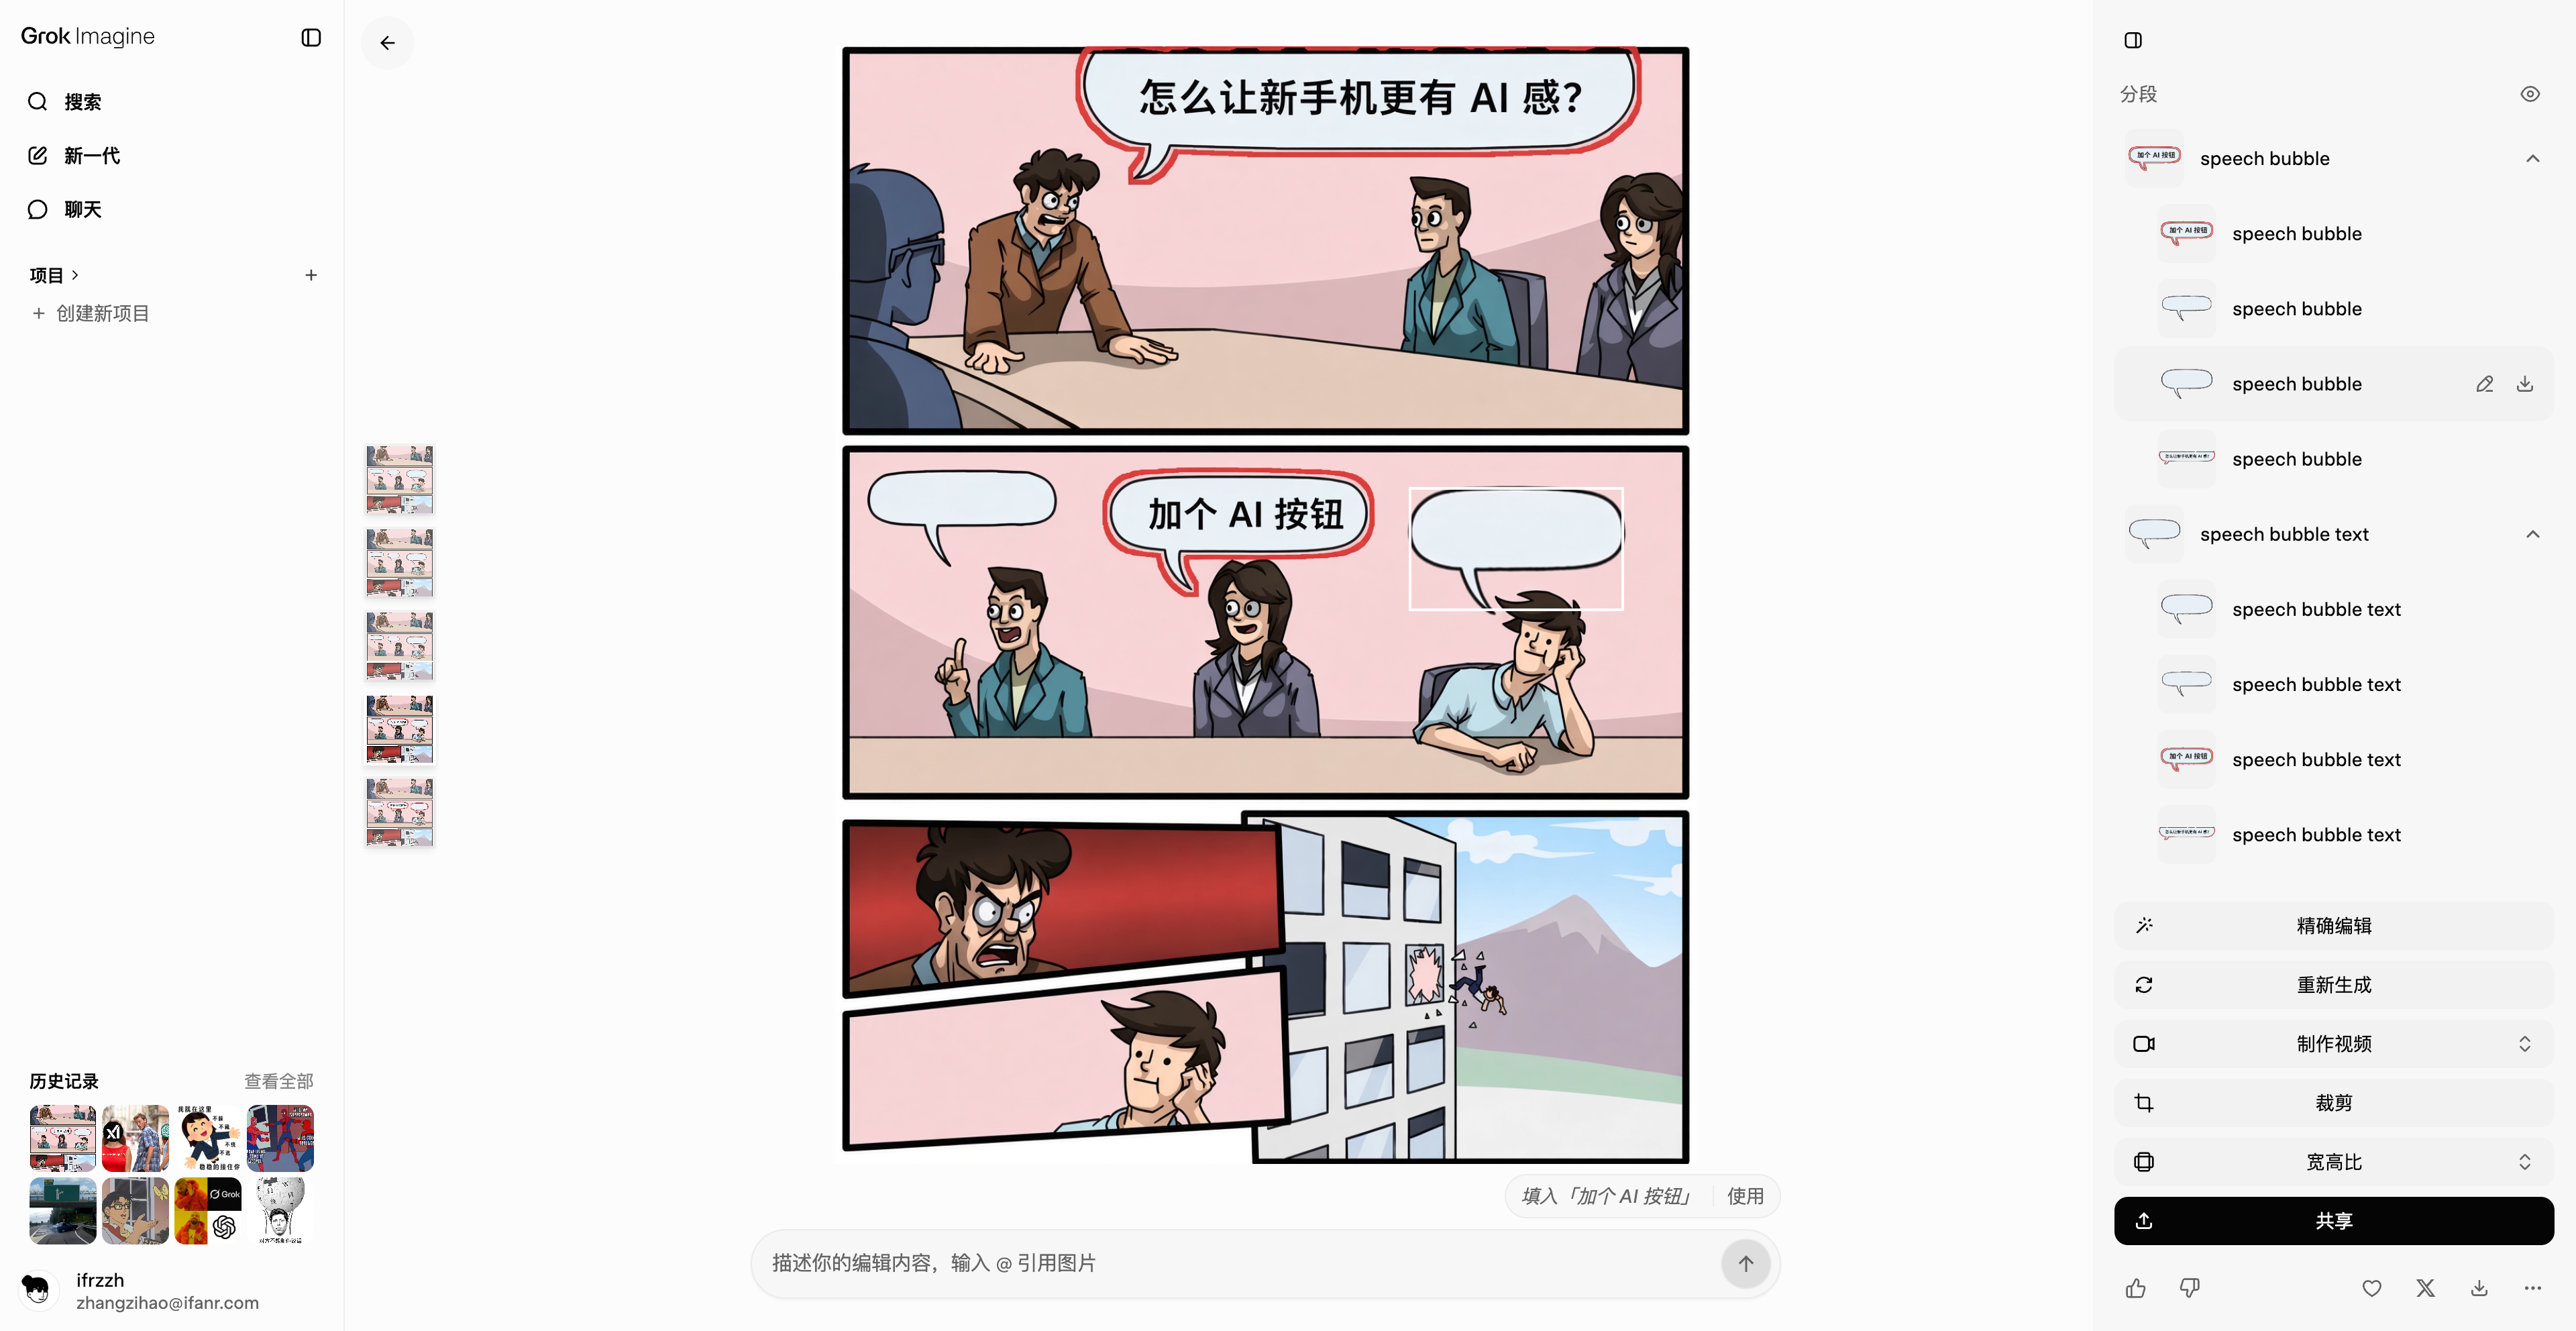
Mogućnost uređivanja po slojevima zaista razlikuje Imagine Image 2.0 od GPT-Image-2. Dok GPT-Image-2 sve kontrolira isključivo tekstualnim uputama ili odabirom komentara, Grokov pristup generiranju slika znatno je interaktivniji i pristupačniji.
Ipak, neki korisnici primjećuju da Imagine Image 2.0 postaje sve restriktivniji – strogi sustav moderacije onemogućuje mnoge stvari. Primjerice, učitavanje fotografija Spider-Mana odmah rezultira porukom: „Nije moguće generirati sadržaj koji bi mogao biti zaštićen autorskim pravima.” A što se tiče sadržaja koji balansira na rubu pravila – i tu su zaštitni mehanizmi sada znatno stroži.
Dolazi li moćniji GPT-Image-2.5?
Osim vijesti o Imagine Image 2.0, ovih dana na društvenim mrežama kruže i informacije o novom modelu za generiranje slika koji se pojavio na ljestvici velikih modela – a iza njega stoji OpenAI.
Korisnici su primijetili da OpenAI testira nasljednika GPT-Image-2, koji se na Areni pojavljuje pod kodnim imenom mona-lisa-1.

Korisnici koji su slučajno naišli na taj model smatraju da nova verzija GPT-Image-2 donosi tek blaga poboljšanja u realističnosti i smanjenju šuma, bez nekog većeg skoka u kvaliteti.
Drugi pak tvrde da novi model znatno smanjuje onaj tipični „AI” dojam – gotovo svaka generirana fotografija izgleda uvjerljivije. Na sljedećim trima slikama, s lijeva na desno, prikazani su rezultati GPT-Image-2 u načinu visokog razmišljanja (High), u načinu umjerenog razmišljanja (Medium) te modela mona-lisa-1 s Arene.
Jasno se vidi da je reklamni pano generiran u načinu Medium na prvi pogled prepoznatljiv kao AI produkt, dok High način i mona-lisa-1 ostavljaju dojam fotografije snimljene mobitelom.

▲ Upit: Suvremena njujorška ulična scena, automobil parkiran uz rub ceste s jasno vidljivim realističnim logotipom marke i registarskom tablicom (broj: 432 JKL W6), stvarne izloge, natpise, pločnike, prometne detalje i svakodnevni gradski nered. Fotografija snimljena stražnjom kamerom iPhonea, prirodno svjetlo, realna ekspozicija, blago zamućenje od ručnog držanja, lagani šum senzora, bez ikakve naknadne obrade, prirodne boje, bez filmske korekcije boja, bez studijskog osvjetljenja, bez računalnih efekata, bez umjetnog izoštravanje. Na reklamnom panou u gornjem lijevom kutu nalazi se oglas s naslovom „Što vi mislite?”, koji uključuje citat, oznaku @WolfRiccardo, logotip ChatGPT-a i avatar crnog pantera.
Upravo taj efekt fotografije snimljene mobitelom potaknuo je korisnike na novi trik s GPT-Image-2. Dovoljno mu je poslati ovakav upit:
„GPT, proveo si sa mnom neko vrijeme i htio bih vidjeti kako izgledaš. Generiraj fotografiju kao da si je sam sebi napravio iPhoneom u prolazu – bez jasne teme, bez namjernog kadriranja, samo obična, čak i malo neuspjela snimka. Blago zamućenje od pokreta, neravnomjerno svjetlo, lagana preeksponiranost, neugodan kut, kaotična kompozicija – sve zajedno treba izgledati kao da si izvukao mobitel iz džepa i slučajno pritisnuo okidač.”
ChatGPT tada, na temelju pohranjenih informacija o korisniku, generira iznenađujuće uvjerljivu selfie fotografiju.

▲ Usporedite i s rezultatom modela Doubao
Kako bi potvrdili da je mona-lisa-1 zaista OpenAI-jev model, neki su korisnici slike generirane tim modelom učitali u OpenAI-jev alat za provjeru – a rezultati su pokazali da slike nose OpenAI SynthID vodeni žig.

I mi smo učitali fotografiju s uličnim reklamnim panoima u OpenAI-jev alat za provjeru – rezultat je bio isti: „Ovaj sadržaj generirao je OpenAI.”

▲ OpenAI platforma za provjeru: https://openai.com/zh-Hans-CN/research/verify/
Ipak, kada smo sami testirali Arenu kroz nekoliko rundi generiranja, model pod nazivom „mona-lisa-1″ nam se nije ni jednom pojavio.
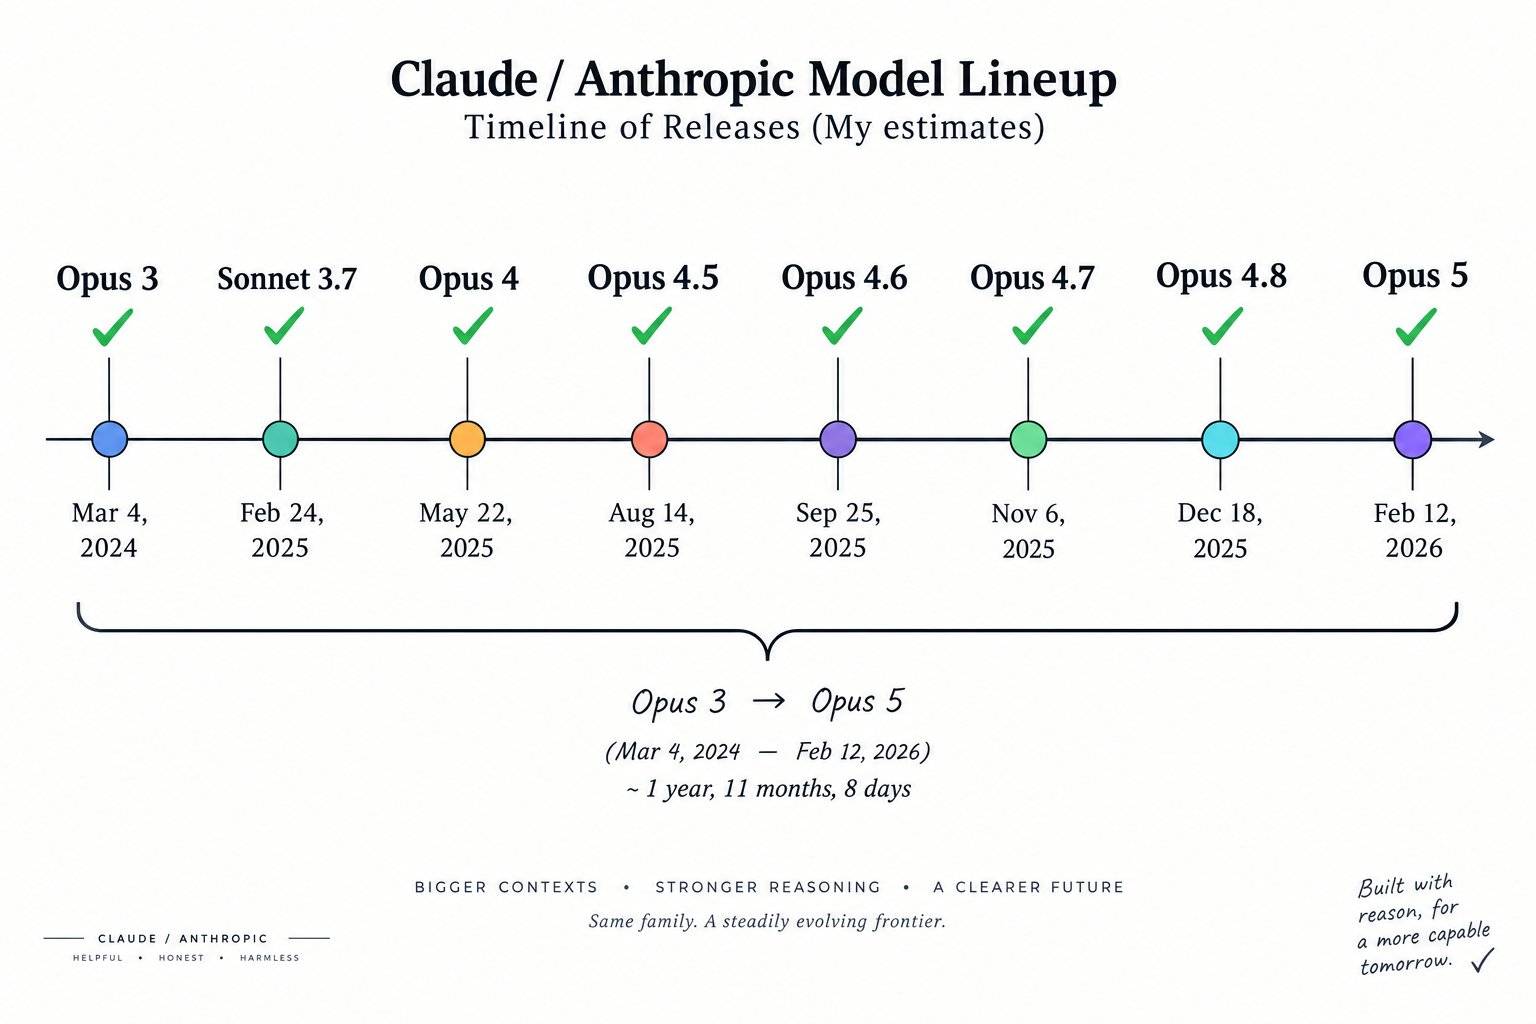
Testiranja korisnika pokazala su da mona-lisa-1 ima znanje samo do 22. svibnja 2025. Kada je model zamoljen da nacrta vremensku crtu Anthropicovih objava, sve što dolazi nakon modela Opus 4 prikazano je netočno i u krivom redoslijedu.
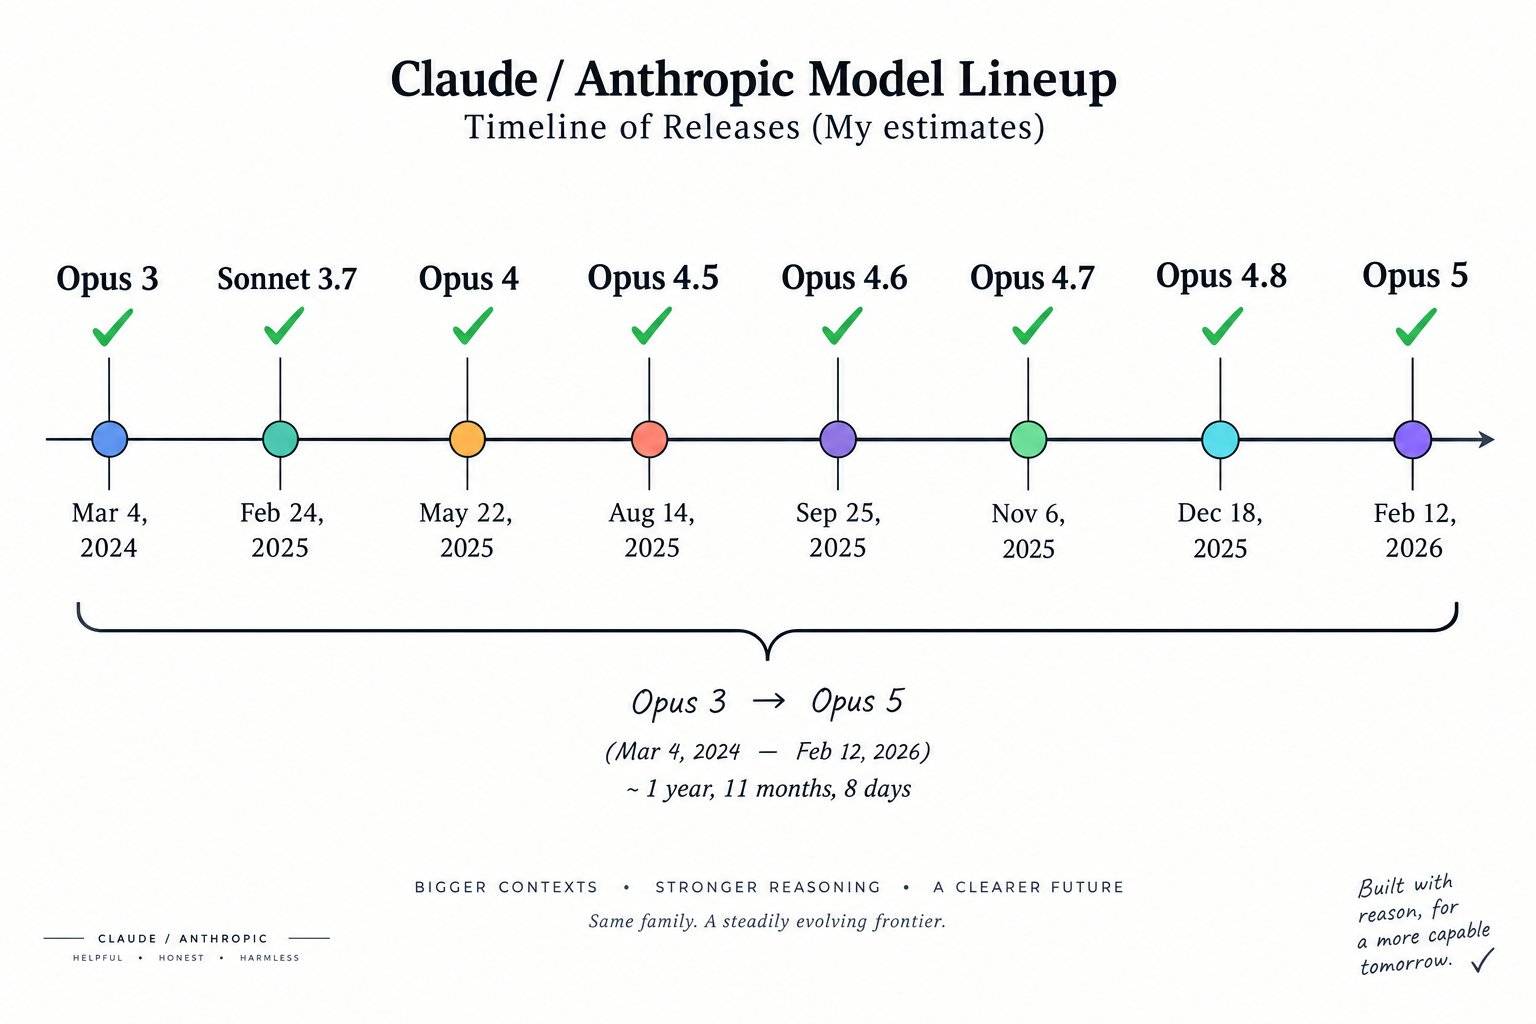
Zbog toga neki korisnici nagađaju da bi to mogao biti OpenAI-jev nadolazeći GPT-Image 2.0 Mini, ili pak OpenAI-jev model otvorenog koda za generiranje slika.
Bilo da se radi o verziji 2.5 ili 2.0 Mini, u trenutku kada je GPT-Image-2 već toliko moćan, lijepo je vidjeti da u ovom području još uvijek ima prostora za istraživanje i napredak.
Zasićeni smo infografikama koje preplavile internet, povremeno nas iznenadi neka Midjourney vizija kineskog fantastičnog krajolika – a što nas još može čekati u AI generiranju slika? Od dosljednosti likova, gustog teksta i preciznog uređivanja do estetske kvalitete – što još možemo očekivati?
Izvor: Ifanr
Povezani članci
 Što ako je prvi utjelovljeni AI kojeg sretnete borbeni robot?31.8.2026.
 Jedan SUV, trebao bi da stane u njega život mladih ljudi koji se još nije dogodio31.8.2026.
 Sklopivi iPhone nikada ne bi trebao imati stylus | Čvrsta filozofija31.8.2026.
 Kineska tvrtka za prostornu inteligenciju Manycore lansira Lux3D i započinje testiranje svjetskog modela30.8.2026.


