23. listopada 2026.
Ključne točke
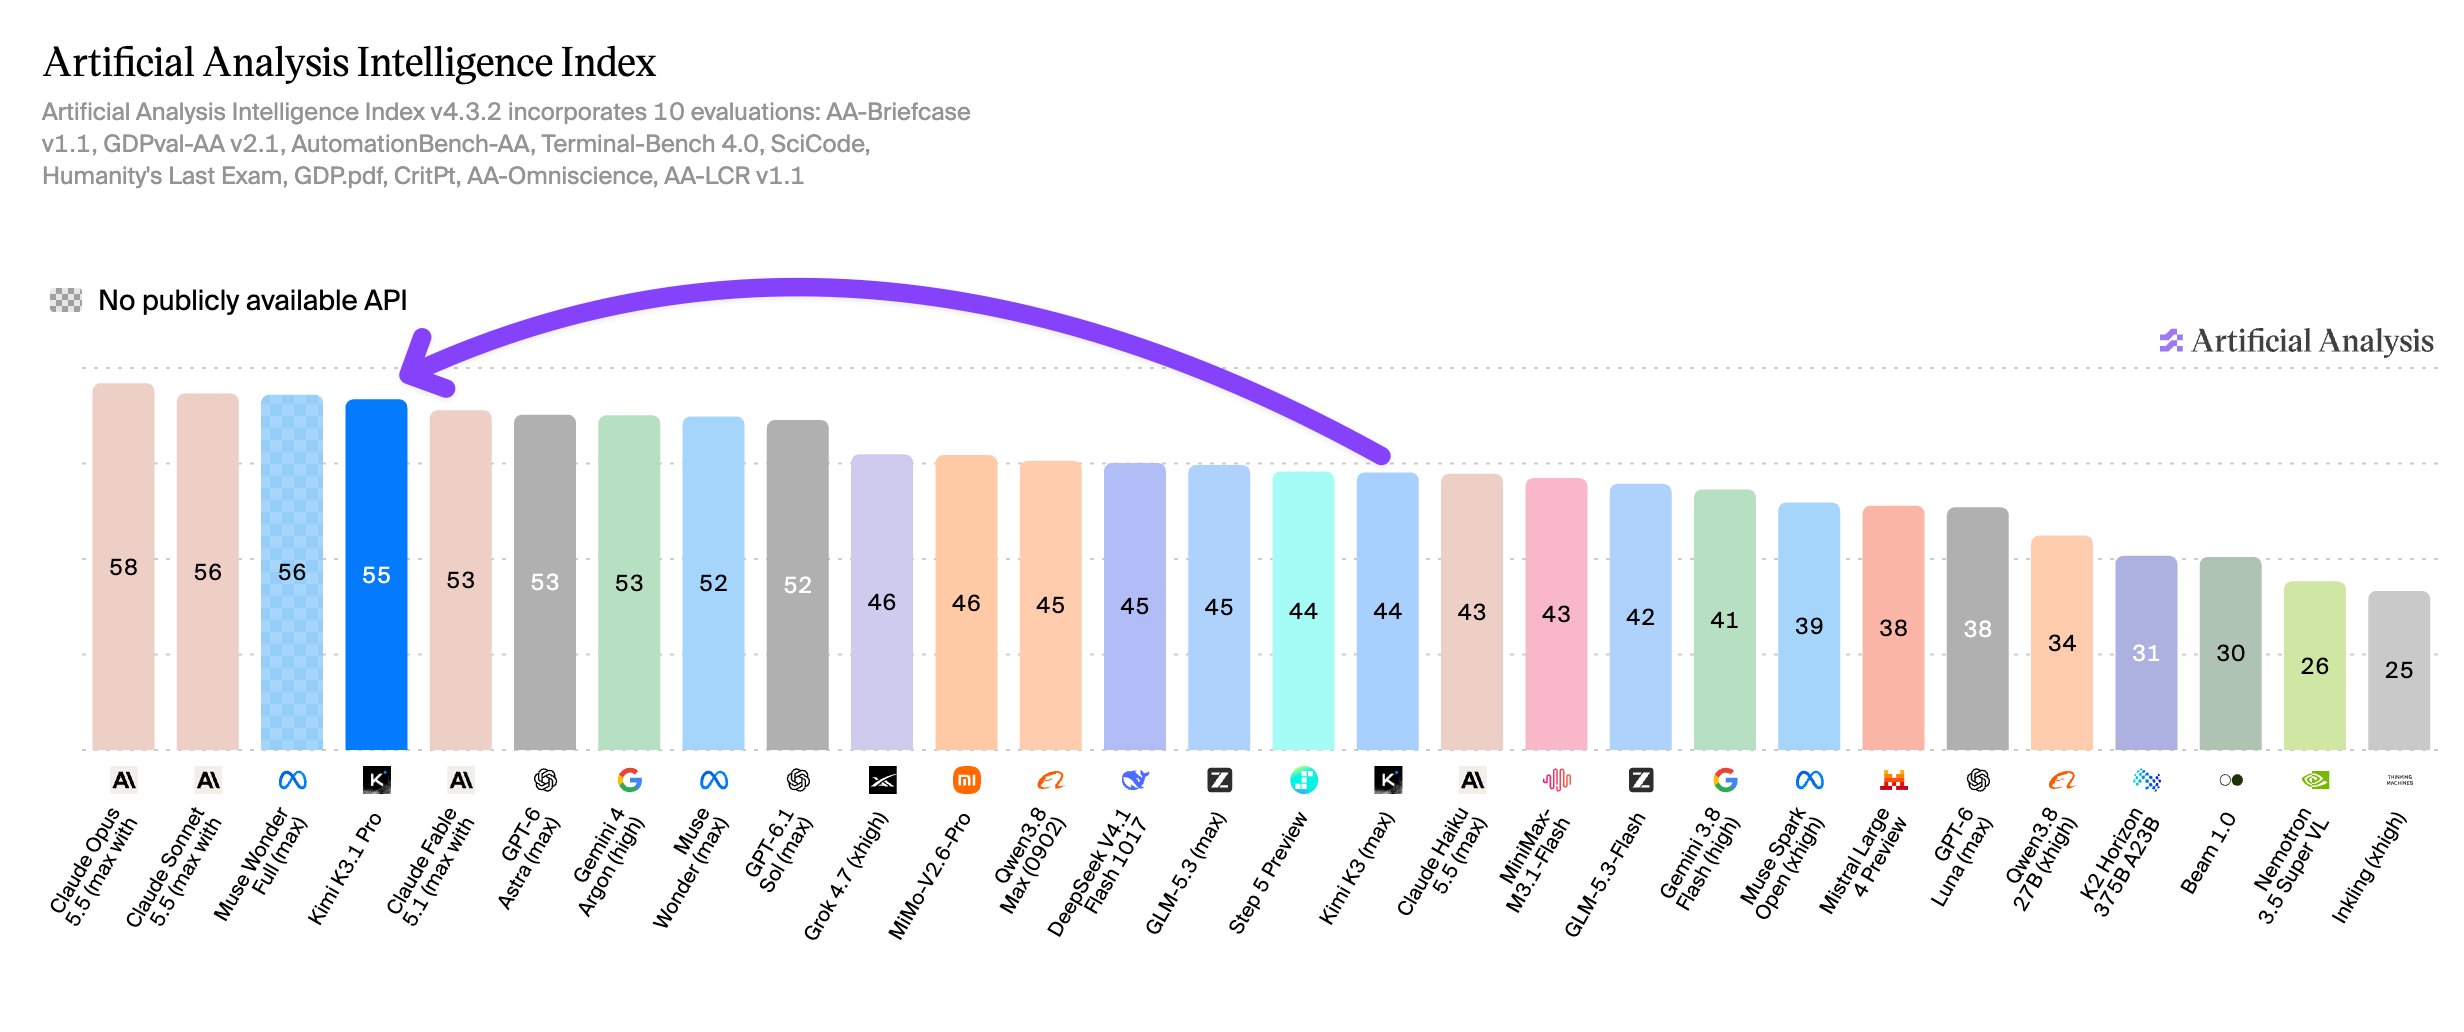
- Kineska tvrtka Moonshot AI objavila je Kimi K3.1 Pro, koji je odmah skočio na četvrto mjesto Artificial Analysis Intelligence Indexa s 55 bodova, tik iza Claude Opus 5.5.
- Model bilježi znatna poboljšanja u agentskim zadacima, programiranju i 3D modeliranju.
- Broj parametara ostaje na 2,8 bilijuna, no cijene API-ja padaju za 33 posto. Moonshot planira objaviti težine modela do studenog 2026.
Novi model zaključivanja tvrtke Moonshot AI, Kimi K3.1 Pro, odmah se plasirao na četvrto mjesto Artificial Analysis Intelligence Indexa – samo 3 boda iza vodećih vlasničkih modela.
Kineska tvrtka Moonshot AI objavila je Kimi K3.1 Pro, post-trenirani nasljednik modela Kimi K3 koji je prošao kroz znatno intenzivnije post-treniranje. Na Artificial Analysis Intelligence Indexu model osvaja 55 bodova – što je skok od 11 bodova u odnosu na K3 – i smješta se na četvrto mjesto ljestvice.
Ispred njega nalaze se jedino Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) i Muse Wonder Full (56), prema podacima Artificial Analysisa. Ako Moonshot do 4. studenog 2026. objavi težine modela kako je najavljeno, K3.1 Pro postao bi model s otvorenim težinama koji postiže najviši rezultat na ljestvici. Time bi se jaz između otvorenih i vlasničkih modela smanjio s dosadašnjih 12 na svega 3 boda – pod uvjetom da se do tada ništa drugo ne promijeni.
Uz K3.1 Pro, Moonshot istovremeno lansira i varijantu K3.1 Pro Highspeed, koja je prema navodima tvrtke dva do tri puta brža. Oba modela već su dostupna putem Kimi.ai, Kimi Work, Kimi Code i Kimi API-ja.
| Stavka | Kimi-K3.1-Pro | Kimi-K3.1-Pro-Highspeed |
|---|---|---|
| Ulaz | $2,00 / MTok | $4,00 / MTok |
| Izlaz | $10,00 / MTok | $20,00 / MTok |
| Predmemorija (ulaz) | $0,20 / MTok | $0,20 / MTok |
Najveći napredak u agentskim zadacima
Najizraženija poboljšanja K3.1 Pro pokazuje upravo u agentskim zadacima. Na GDPval-AA benchmarku dostiže 1.846 Elo bodova prema podacima Artificial Analysisa, što je 312 bodova više nego K3, i smješta ga tik iza Claude Opus 5.5 (1.866) i Muse Wonder Full (1.857). Na Terminal-Bench 4.0 Moonshot bilježi rezultat od 65,7 posto, čime model nadmašuje GPT-6 Astra (58,2 posto) i jedva zaostaje za Claude Opus 5.5 (66,4 posto). K3 je na istom testu postigao svega 13 posto.
Znatno su se smanjile i stope halucinacija. Na internom Moonshot benchmarku Kimi Hallu Bench Hard, halucinacije na razini tvrdnji pale su s 23,4 posto (K3) na 8,3 posto, navodi tvrtka. Moonshot napominje da je riječ o stres-testu, a ne o općoj mjeri pogrešaka. GPT-6 Astra na istom benchmarku postiže 5,5 posto, pa još uvijek drži prednost.
Na internim financijskim benchmarkovima K3.1 Pro ostvario je napredak od 7,2 boda na Financial Modelingu i 11,6 bodova na Financial Researchu. Što se tiče općih uredskih zadataka, model prema Moonshotu nadmašuje sve testirane modele na OfficeQA Pro v2.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 | DeepSeek-V4.1-Flash | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 | 66,4 | 58,2 | 57,9 | 42,3 | 41,8 |
| SWE Marathon v1.1 | 51,7 | 46,3 | 42,5 | 45,6 | 40,0 | 42,5 |
| DeepSWE v1.1 | 75,5 | 74,2 | 74,1 | 67,4 | 77,0 | 66,9 |
| BenchCAD (s alatima) | 92,7 | 96,2 | 95,9 | 92,6 | 81,6 | — |
| HLE-Full (s alatima) | 70,0 | 67,7 | 57,2 | 65,6 | 58,8 | 62,5 |
| BrowseComp | 92,1 | 90,8 | 91,5 | — | — | — |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | 54,5 | 40,4 | 31,1 |
| Automation Bench-AA | 73,3 | 69,5 | 68,5 | 59,4 | 66,6 | 62,2 |
| GDPval-AA v2.1 (Elo) | 1.846 | 1.866 | 1.573 | 1.754 | 1.746 | 1.650 |
| GPQA-Diamond | 94,2 | 93,9 | 96,1 | 93,7 | 92,2 | 91,7 |
| ExploitBench | 74,7 | 91,0 | 100 | 83,0 | — | 54,4 |
Tablica benchmarkova za Moonshot Kimi K3.1 Pro. Svi rezultati mjereni su uz razinu zaključivanja postavljenu na „max”.
3D modeliranje i programiranje
K3.1 Pro izravno radi s pogonima za igre poput Unitya, Unreal Enginea i Godota, i to kako za brze ispravke grešaka, tako i za izgradnju čitavih projekata, navodi Moonshot. Na BenchCAD benchmarku s alatima postiže 92,7 posto, što ga stavlja blizu Claude Opus 5.5 (96,2 posto) i GPT-6 Astre (95,9 posto). Bez alata dostiže 72,8 posto, gotovo izjednačivši se s Claude Opus 5.5 (73,0 posto).
Moonshot ističe da je model posebno jak u parametarskom modeliranju mehaničkih dijelova, arhitektonskih modela i konfigurabilnih proizvoda. Može pisati i pokretati skripte za Blender i CAD softver bez MCP konektora. Tvrtka je uz to na Kimi.com pokrenula i funkciju pod nazivom „3D Make” koja korisnicima omogućuje pregled, uređivanje i izvoz 3D modela.
Iste dimenzije, niže cijene
K3.1 Pro zadržava iste dimenzije kao K3 – 2,8 bilijuna ukupnih parametara i 104 milijarde aktivnih. Kontekstni prozor seže do milijun tokena, a model obrađuje i tekst i slike. Prema Artificial Analysisu, model se nalazi na vrhu Pareto granice: nema modela s usporedivim brojem parametara koji postiže viši rezultat na Intelligence Indexu.
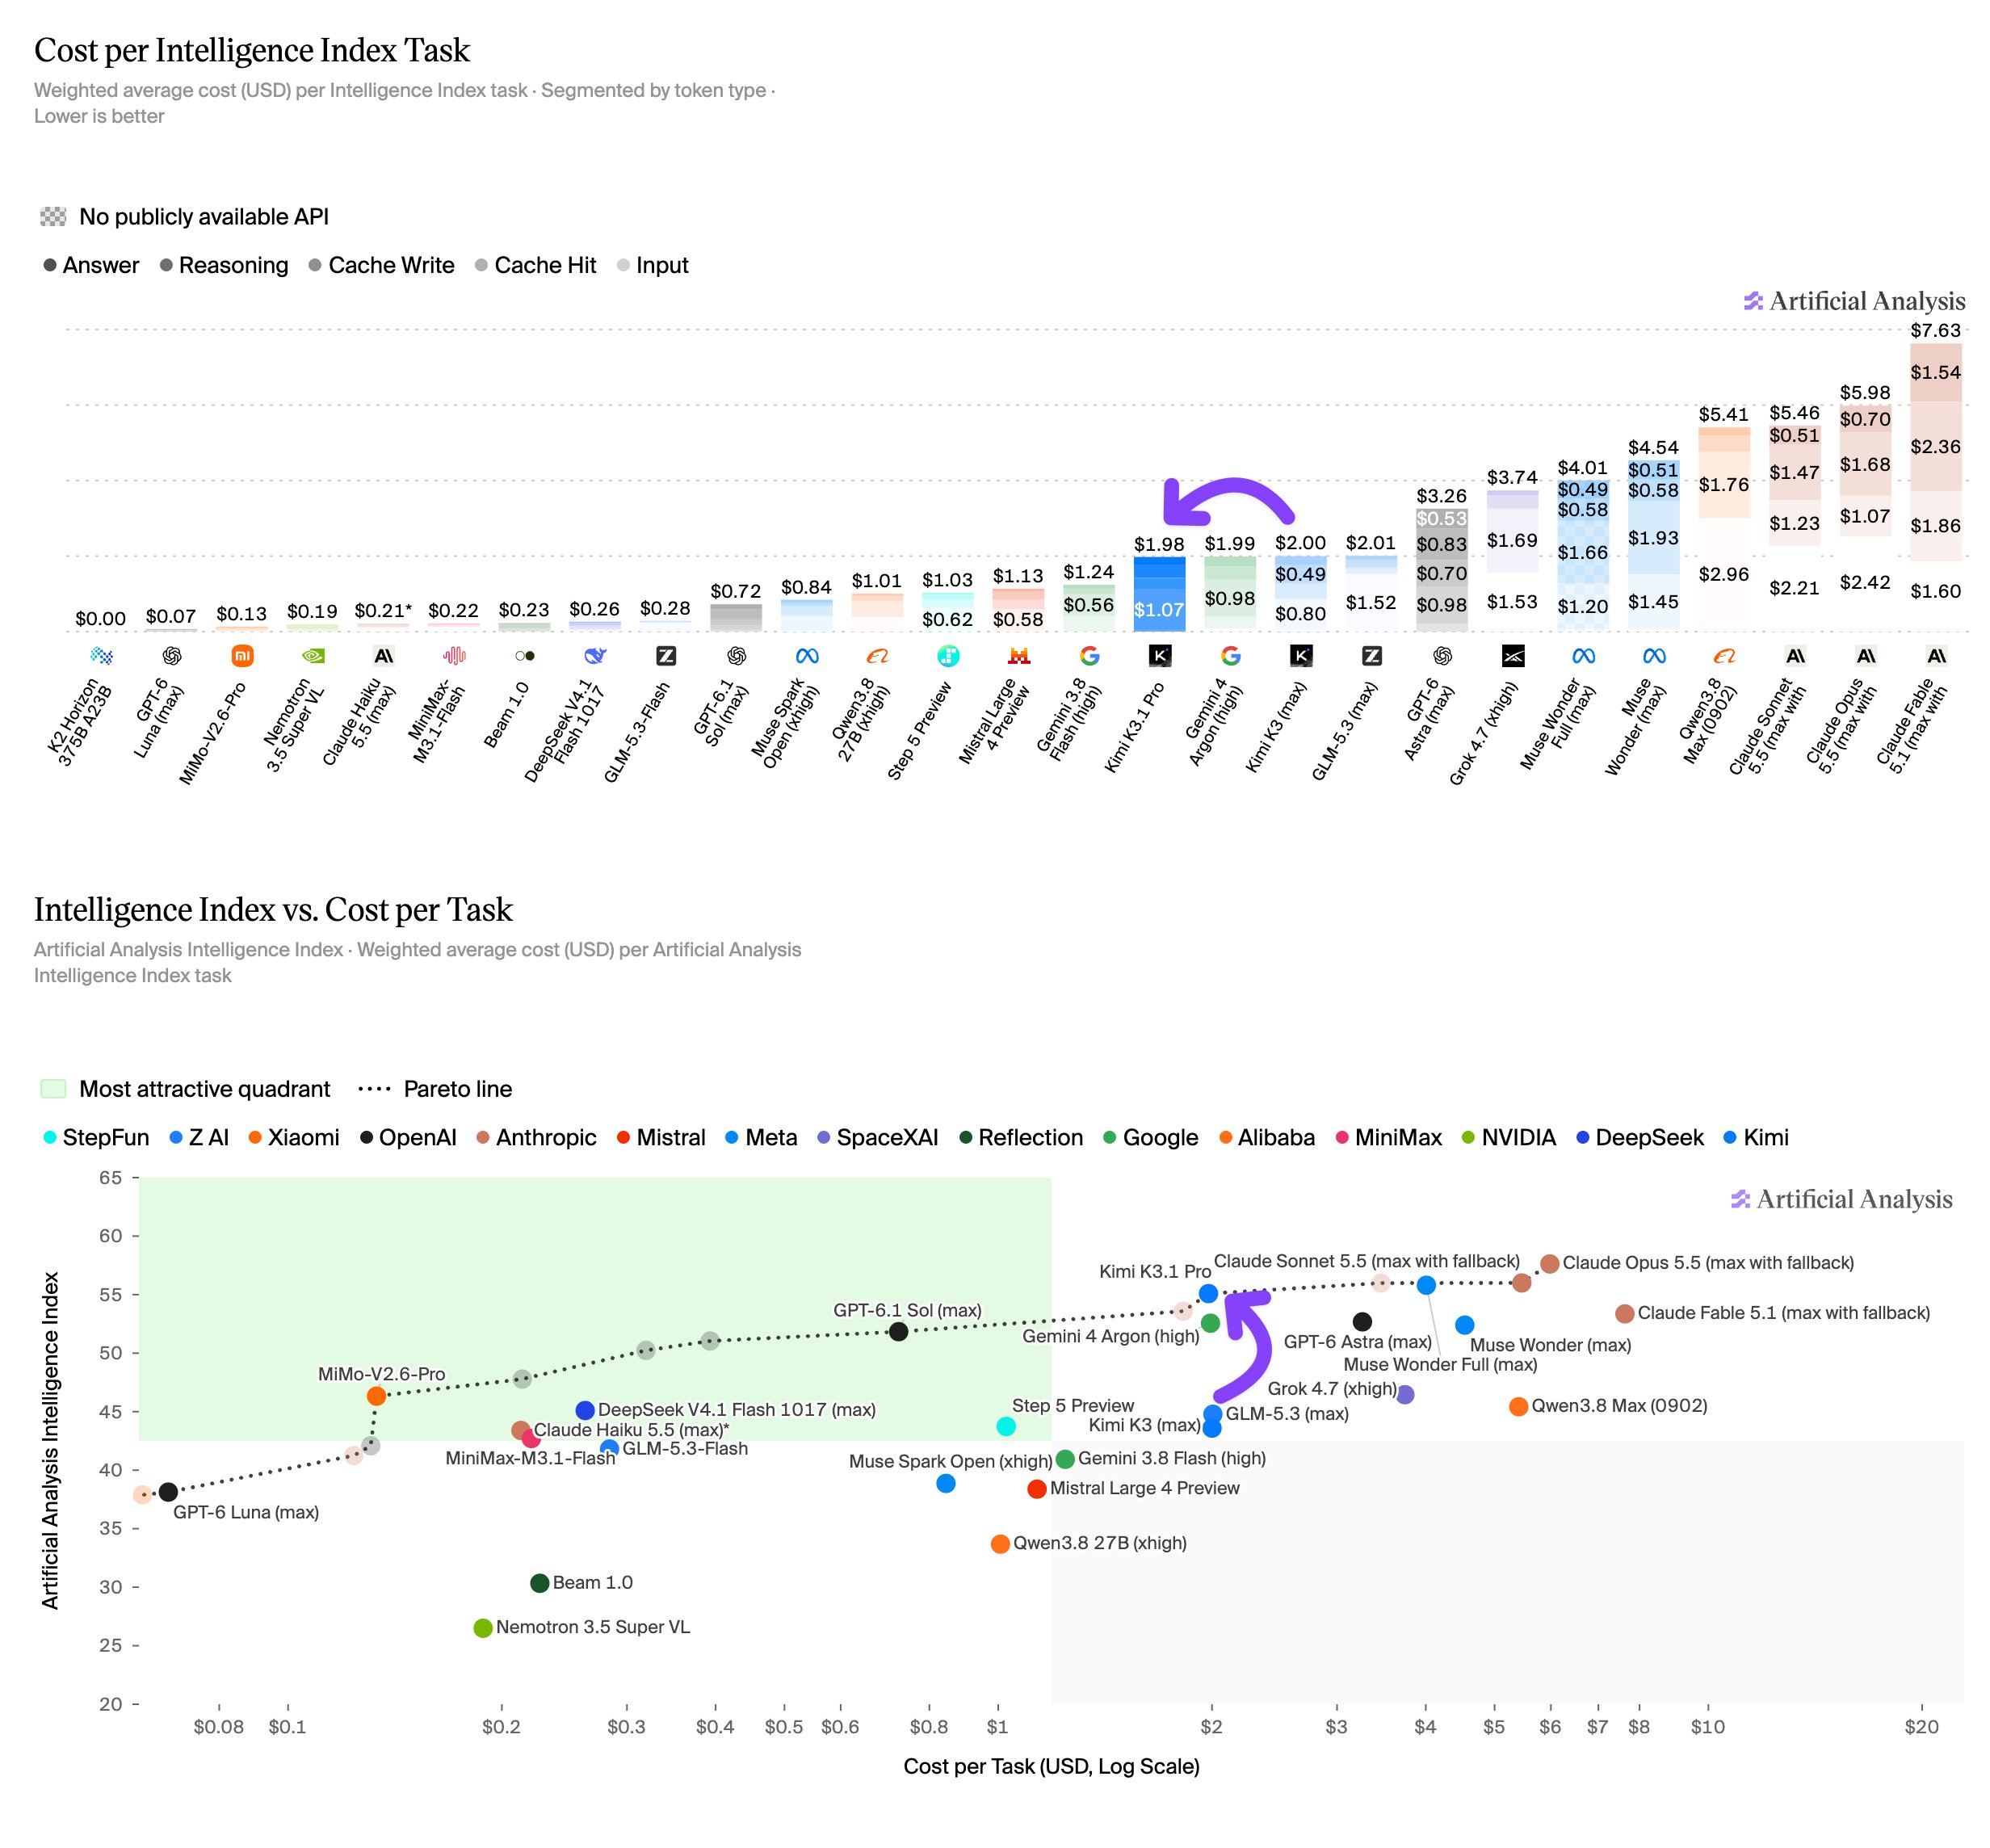
Cijene tokena padaju za 33 posto. Ulaz sada košta $2 po milijunu tokena (ranije $3), izlaz $10 (ranije $15), a pogodak u predmemoriji $0,20 (ranije $0,30). Svaki zadatak na Intelligence Indexu košta $1,98 – gotovo jednako kao i K3 ($2,00) – jer model generira 14 posto više izlaznih tokena.
Kibernetička sigurnost i namjerno ograničavanje ofenzivnih sposobnosti
Moonshot u svom tehničkom blogu čitav jedan odjeljak posvećuje kibernetičkoj sigurnosti. Tvrtka navodi da su sposobnosti istraživanja ranjivosti rasle kako se povećavalo post-treniranje, budući da je sadržaj vezan uz kibernetičku sigurnost bio ugrađen u opći korpus za srednje treniranje, a srodni zadaci bili su dio mješavine RL okruženja.
Za objavu s otvorenim težinama Moonshot je iz obiju faza treniranja uklonio podatke vezane uz kibernetičku sigurnost. Na internom benchmarku xdev-bench-hard, koji reproducira nedavno otkrivene ranjivosti u softveru poput Linux kernela, Node.js-a i JavaScriptCorea, neočišćena verzija rješava 90,5 posto zadataka. Nakon čišćenja podataka, K3.1 Pro rješava 81,0 posto. DeepSeek-V4.1-Flash na istom testu dostiže 85,7 posto, dok je Kimi K3 postigao 33,3 posto.
Moonshot smatra da nijedan model s otvorenim težinama ne bi trebao gurati apsolutnu granicu ofenzivnih kibernetičkih sposobnosti. Istovremeno, tvrtka želi postupno podizati ljestvicu za otvorene modele, jer oni služe i u obrambene svrhe – primjerice za reviziju naslijeđenih sustava. Anthropic je ranije pokazao da čak i GLM-5.3, koji na AA Indexu postiže 45 bodova, može pisati exploite na razini blizu Claude Mythosa.
Izvor: The Decoder
Povezani članci
 Recursive prikazuje prvi rezultat svog istraživačkog procesa vođenog umjetnom inteligencijom s Flintom23.10.2026.
 OpenAI-jev GPT-5.6 Sol i Googleov Gemini 4 Argon otkrili su kritičnu PHP ranjivost koja utječe na milijune web stranica21.10.2026.
 Elevenlabs objavljuje dva nova modela govora u govor dizajnirana za razgovore s umjetnom inteligencijom u stvarnom vremenu20.10.2026.
 MiniMax M3.1 Flash pokazuje da cjenovna utrka kineske umjetne inteligencije nema dna na vidiku19.10.2026.