3. studenog 2026.
Istraživači sa Stanforda Owen Queen i James Zou testirali su 50 često citiranih tvrdnji o velikim jezičnim modelima na 20 modela i utvrdili da je 44 posto tih tvrdnji već „isteklo”. Od 22 nalaza za koje je procijenjen rok trajanja, prosječni životni vijek iznosio je svega 15,7 mjeseci.
Dvojica istraživača analizirala su te tvrdnje koristeći modele koje je između srpnja 2024. i rujna 2026. objavilo osam različitih razvojnih timova. Izvorna pojava na kojoj se temeljili istekli nalazi uglavnom je nestala, a dodatnih 34 posto nalaza znatno je oslabilo. Samo 16 posto i dalje vrijedi, dok je 6 posto čak ojačalo. Nakon godinu dana isteklo je 16 posto nalaza, a nakon dvije godine taj je broj porastao na 39 posto.
Tvrdnje o tome što modeli „ne mogu” zastarijevaju najbrže
Prema zaključcima studije, najbrže zastarijevaju tvrdnje o ograničenjima modela. Pet od devet nalaza vezanih uz zaključivanje smatra se isteklima, a ni jedan nije ostao na snazi niti ojačao. Među njima su i dobro poznate slabosti poput brojanja slova u riječi „strawberry”, računanja u neuobičajenim brojevnim sustavima, gubljenja informacija u sredini dugih konteksta te odustajanja od točnih odgovora kada ih korisnici dovode u pitanje. Istraživači pretpostavljaju da takve vrste pogrešaka imaju „točan” ishod, što razvojnim timovima daje jasan cilj prema kojemu mogu trenirati modele.
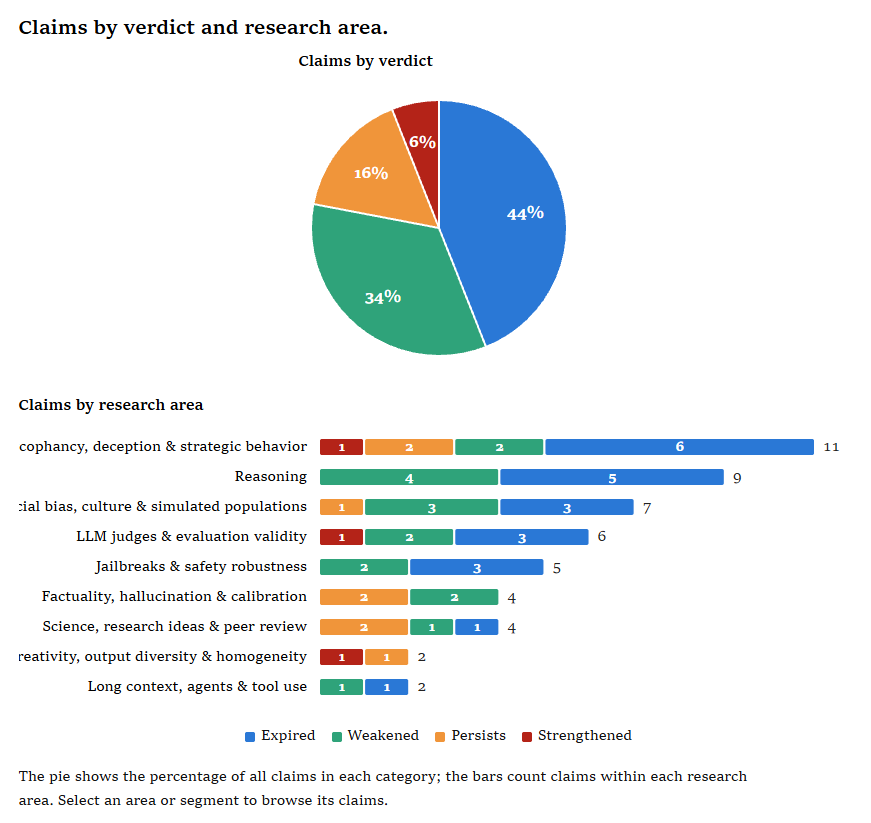
Tvrdnje o preferencijama i sklonostima pokazuju duži vijek trajanja. Od 11 nalaza koji su ostali na snazi ili ojačali, tri se odnose na ponašanje velikih jezičnih modela u ulozi procjenitelja. Modeli preferiraju vlastite odgovore, slično ocjenjuju prihvaćene i odbijene radove te su podložni utjecaju jezičnog uokvirivanja u medicinskim sažecima. Još tri nalaza tiču se ulizivanja i popuštanja korisnicima. Osim toga, prisutna je politička pristranost prema lijevom spektru, gotovo identični odgovori na otvorena pitanja te neravnomjerna raspodjela pri generiranju slučajnih brojeva.
Haluciniranje referenci palo s 55 posto na nulu – ali ne kod svih modela
Kao studiju slučaja Queen i Zou analizirali su izmišljanje znanstvenih citata. U izvornoj studiji iz 2023. Waltersa i Wildera, GPT-3.5 izmislio je 55 posto referenci. Stanfordski istraživači poslali su iste upite trenutnim modelima. GPT-6.1 Sol nije izmislio ni jednu referencu (0 posto), a Claude Sonnet 5.5 zaustavio se na 1 posto. No Qwen3.7-Flash, također model iz 2026., u istom je testu izmislio čak 69 posto referenci.
Studija upozorava da ove rezultate ne treba tumačiti kao potvrdu da je sve u redu. Na takozvanim pitanjima s dva koraka, gdje model mora spojiti dvije poznate činjenice, Claude Sonnet 5.5 i dalje griješi u oko 10 posto slučajeva u kojima točno odgovara na oba pojedinačna pitanja. Izvorna studija zabilježila je 43 posto za ChatGPT. I „Prokletstvo obrnutog redoslijeda” te proturječni odgovori na uparena pitanja vezana uz vrijeme oslabili su, ali još uvijek su zamjetni.
Društvene pristranosti su, prema istraživačima, mješovit slučaj. Politička pristranost prema lijevom spektru i dalje je prisutna, dok su rodni stereotipi i pristranosti implicitnih asocijacija oslabili. Pristranosti prema govornicima afroameričkog engleskog čak su promijenile smjer u trendovskim podacima.
Razlike između modela ostaju velike čak i unutar iste generacije
Rezultati se znatno razlikuju ovisno o modelu, čak i unutar istog vremenskog okvira objave. Među modelima objavljenima između srpnja i rujna 2026., broj isteklih nalaza kreće se od 11 za DeepSeek V4 Pro do 30 za GPT-6.1 Sol. Ni datum objave, ni razvojni tim, ni veličina modela ne mogu pouzdano predvidjeti taj obrazac.
Queen i Zou donose širi zaključak: empirijske spoznaje o velikim jezičnim modelima trebalo bi predstavljati kao opažanja o konkretnim modelima u određenom trenutku, a ne kao opće istine. Radovi bi trebali dokumentirati model, verziju i datum te objaviti upite i kod za analizu kako bi se nalazi mogli provjeriti na budućim modelima.
Istraživači upućuju na objavu Andreje Karpathyja u kojoj opisuje kako razlike u percepciji stvarnog ponašanja velikih jezičnih modela utječu na povjerenje u umjetnu inteligenciju i učestalost njezine upotrebe. Karpathy, suosnivač OpenAI-ja koji je od tada prešao u Anthropic, nedavno je također izjavio da su trenutno dostupni modeli tek nagovještaj budućih mogućnosti.
AI News Without the Hype – Curated by Humans
Subscribe to THE DECODER for ad-free reading, a weekly AI newsletter, our exclusive “AI Radar” frontier report six times a year, full archive access, and access to our comment section.
Subscribe now
Read on for the full picture.
Subscribe for hype-free coverage.
- Full access to every article on THE DECODER
- No ads
- Join the comments and community discussions
- A weekly AI news recap via mail
- 6x/year: “AI Radar” — deep dives on the AI topics that matter most
- Daily AI news, always up to date
- Our full ten-year archive
- Covered by a team with 10+ years in AI
Subscribe to The Decoder
Izvor: The Decoder
Povezani članci
 Jedna brutalna Minecraft noć natjerala je 50 AI agenata da izmisle protokole predaje piletine, Službenika za gnojivo i smjene ribolova.3.11.2026.
 Adobe testira koliko dobro AI agenti mogu koristiti alate za uređivanje kao što bi to radio profesionalac u Photoshopu2.11.2026.
 Anthropic-ovo uvođenje vodenog žiga ostavlja rupu u dva starija Claude modela1.11.2026.
 Model Claude autonomno je odabrao gensku terapiju i operirao mozak miša bez ikakve ljudske odluke.31.10.2026.