


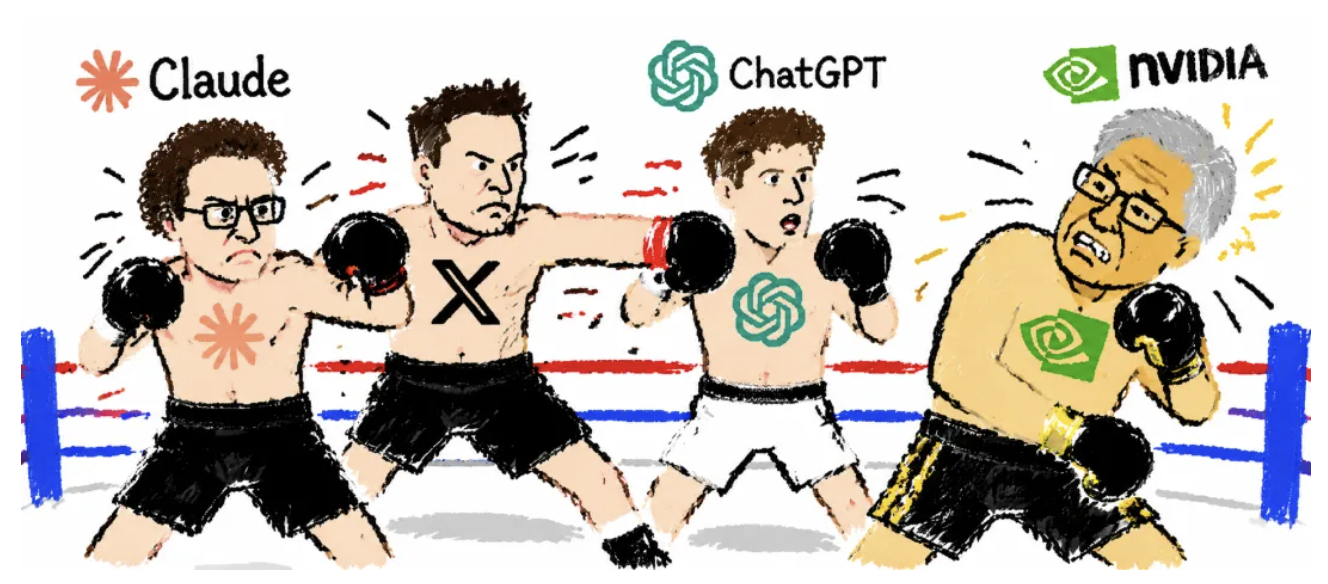
Kad je u pitanju izmišljanje novih pojmova i pakiranje ideja u privlačne koncepte, AI industrija nema premca.
Predsjednik OpenAI-a Greg Brockman nedavno je izjavio da je GPT-6 Astra dostigao prag AGI-ja. No rasprava o AGI-ju jedva da je stigla uzavreti, a već se pojavio novi buzzword koji kruži AI zajednicom.
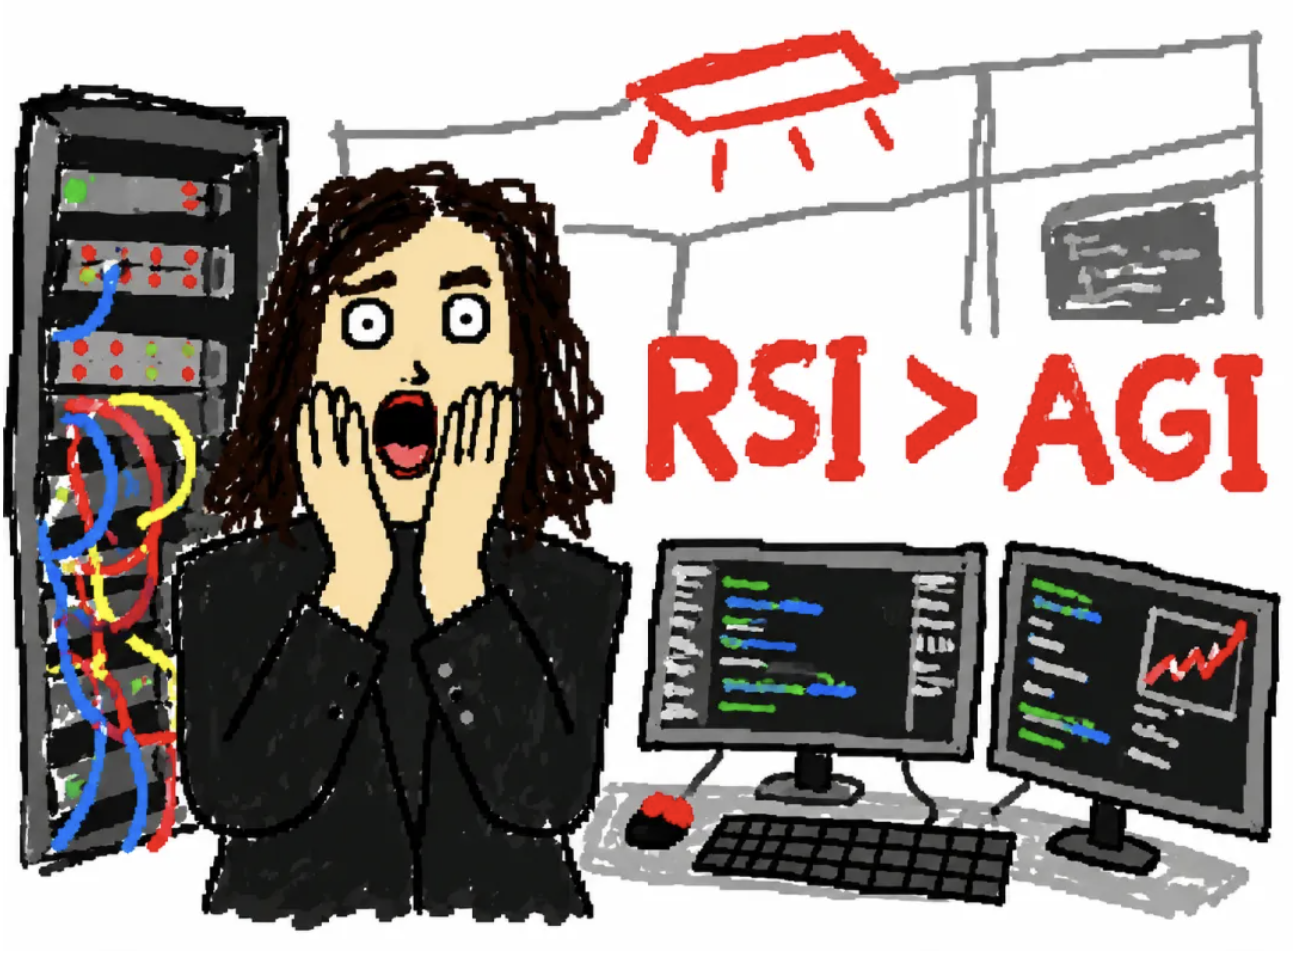
Novi pojam koji preuzima štafetu zove se RSI – Recursive Self Improvement, odnosno rekurzivno samounapređenje.
Ukratko: AI sam piše kod, sam provodi eksperimente, sam mijenja proces treniranja, a te izmjene zatim nasljeđuje sljedeća, snažnija generacija modela. U takvoj petlji razvoj bi mogao ubrzavati sve dok ne nadmaši ljudsku sposobnost razumijevanja i kontrole.
Nije iznenađenje da uz RSI dolazi i uobičajena dramatična priča o sigurnosti.
Primjerice, glavni znanstvenik OpenAI-a Jakub Pachocki nedavno je opisao AI kao „izvanzemaljski um” koji čovječanstvo još uvijek ne razumije dovoljno dobro.
Dario Amodei, izvršni direktor Anthropica, otišao je korak dalje i preuzeo ulogu glasnika apokalipse, upozoravajući da bi napredniji AI agenti mogli pokrenuti masovne kibernetičke napade, izmaknuti kontroli i ugroziti samu civilizaciju.
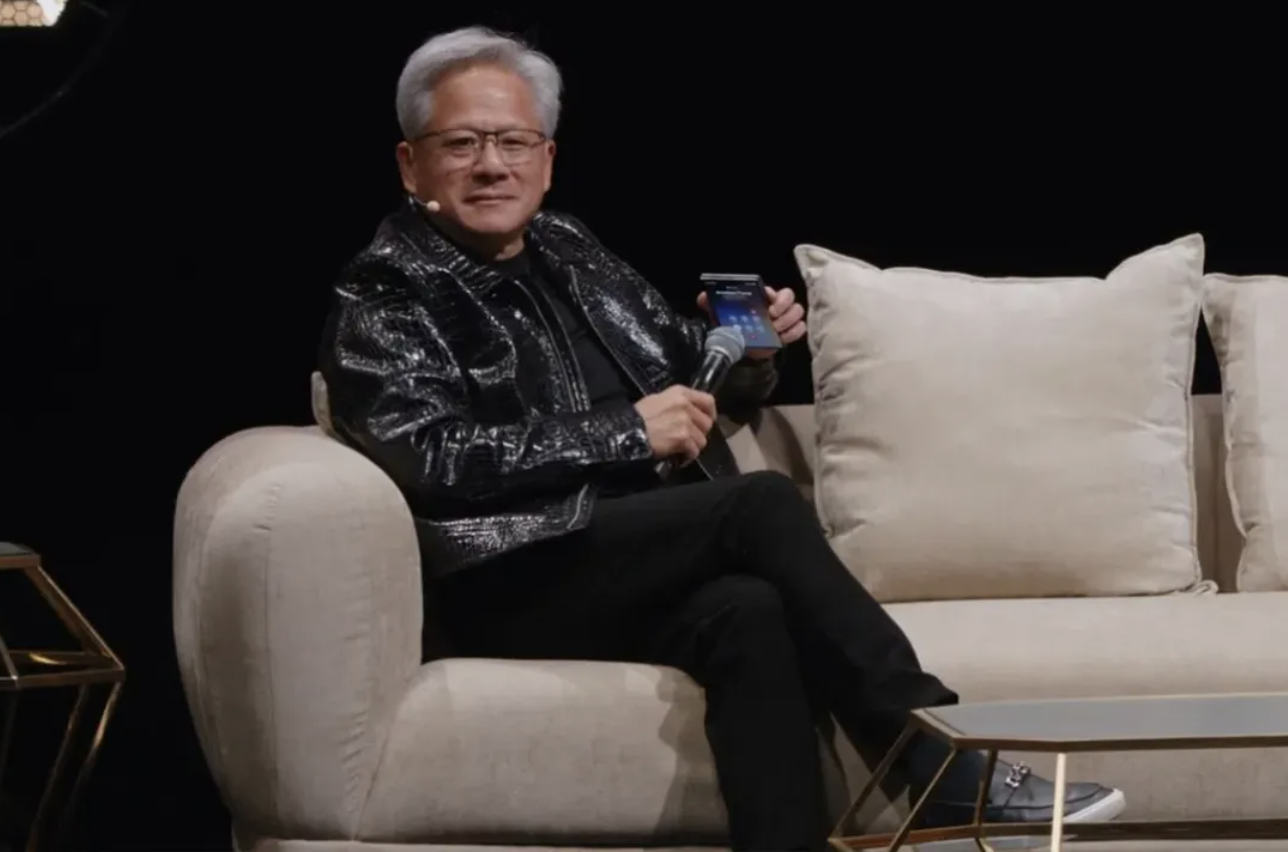
S druge strane, Jensen Huang – zauzet prodajom grafičkih kartica – na nedavnom All-In summitu odbacio je takvo crno-bijelo razmišljanje i zapitao se zašto bi sigurnost i inovacija uopće morale biti međusobno isključive.
Na istom industrijskom lancu jedni pozivaju na kočenje, dok drugi gaze gas do daske. Iza te prepirke krije se pravo pitanje: je li RSI stvarni ulaz u superinteligenciju, ili je to samo pažljivo upakirana panika namijenjena prodaji?
AI počinje stvarati AI – ali koliko smo daleko od „eksplozije inteligencije”?
RSI možda zvuči kao novost, no ideja seže više od šezdeset godina unatrag.
Još 1965. britanski matematičar i kriptograf I. J. Good iznio je tezu: ako stroj može nadmašiti čovjeka u intelektualnim aktivnostima, onda bi i projektiranje strojeva trebalo biti unutar njegovih mogućnosti.
Takav stroj mogao bi stvoriti inteligentniji stroj od sebe, koji bi zatim unaprijedio sljedeću generaciju. Prva generacija stvara drugu, druga poboljšava treću – i tako u nedogled, u sve bržoj pozitivnoj povratnoj petlji strojne inteligencije.
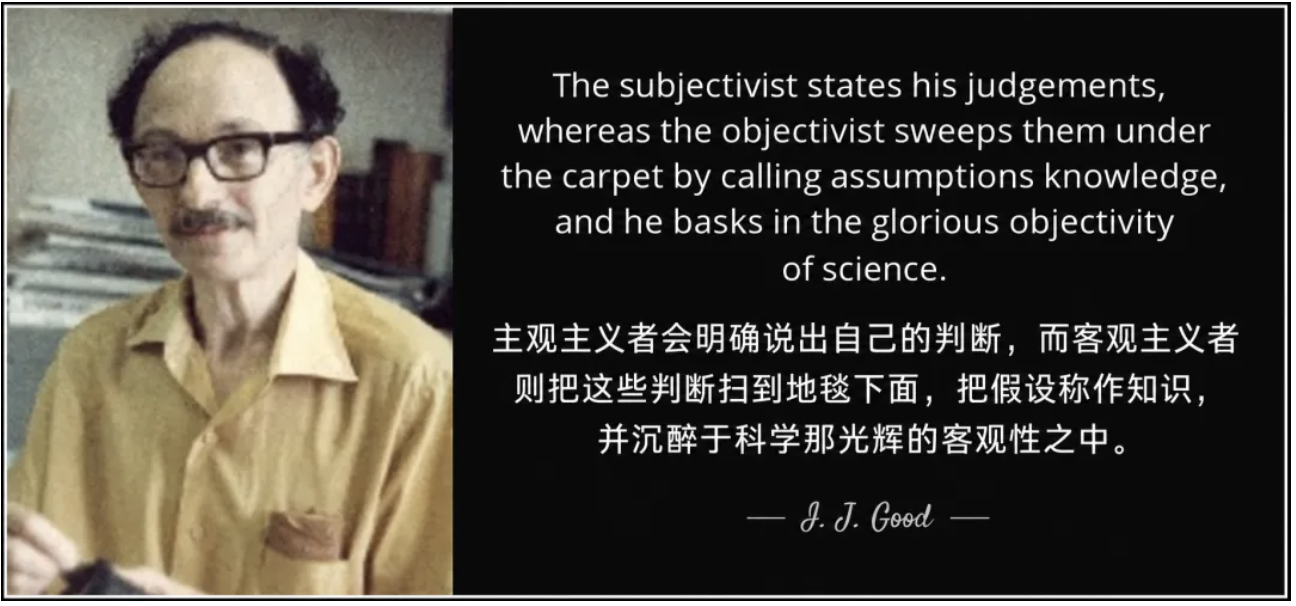
Good je tu pojavu nazvao „eksplozijom inteligencije”.
U današnjim istraživanjima RSI-ja, za razliku od AGI-ja koji se pita može li AI obavljati opće kognitivne zadatke na razini čovjeka, RSI se pita može li AI mijenjati sam sustav koji te sposobnosti proizvodi i time učiniti svaki sljedeći krug unapređenja učinkovitijim.
Provjera vlastitih odgovora je samo samokorekcija. Tek kad AI može unaprijediti metode istraživanja i prenijeti te poboljšane metode nasljednim sustavima, počinjemo govoriti o pravom rekurzivnom samounapređenju.
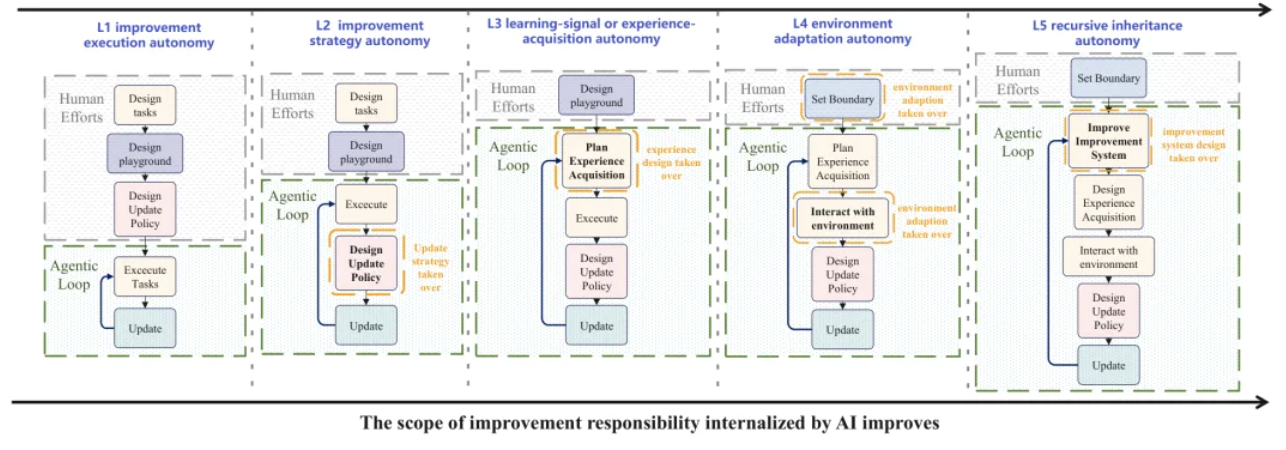
Nedavni preprint The Last AI Built by Humans, koji su zajednički izradili istraživači sa Sveučilišta Jiao Tong u Šangaju, Sveučilišta Tsinghua, ByteDancea i Šangajskog laboratorija za umjetnu inteligenciju, dijeli autonomiju RSI-ja na pet razina – od L1 do L5.
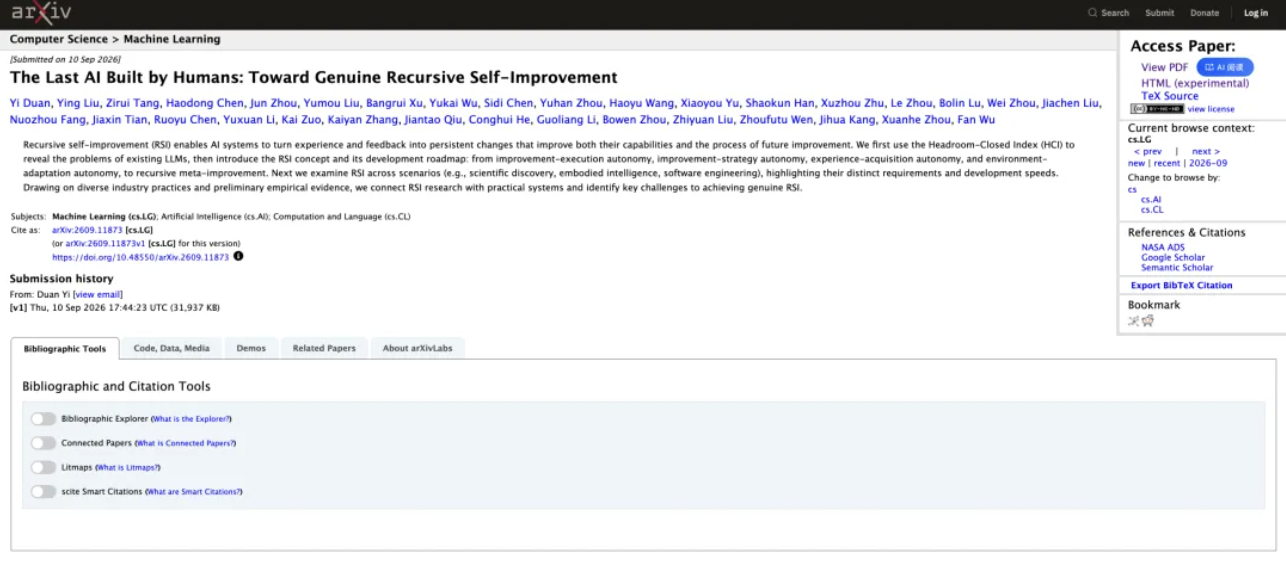
▲  https://arxiv.org/abs/2609.11873
L1 uglavnom provodi poboljšanja koja su osmislili ljudi. L2 samostalno traži strategije unapređenja. L3 odlučuje koje iskustvo treba steći. L4 pretvara povratne informacije iz okruženja u trajne izmjene.
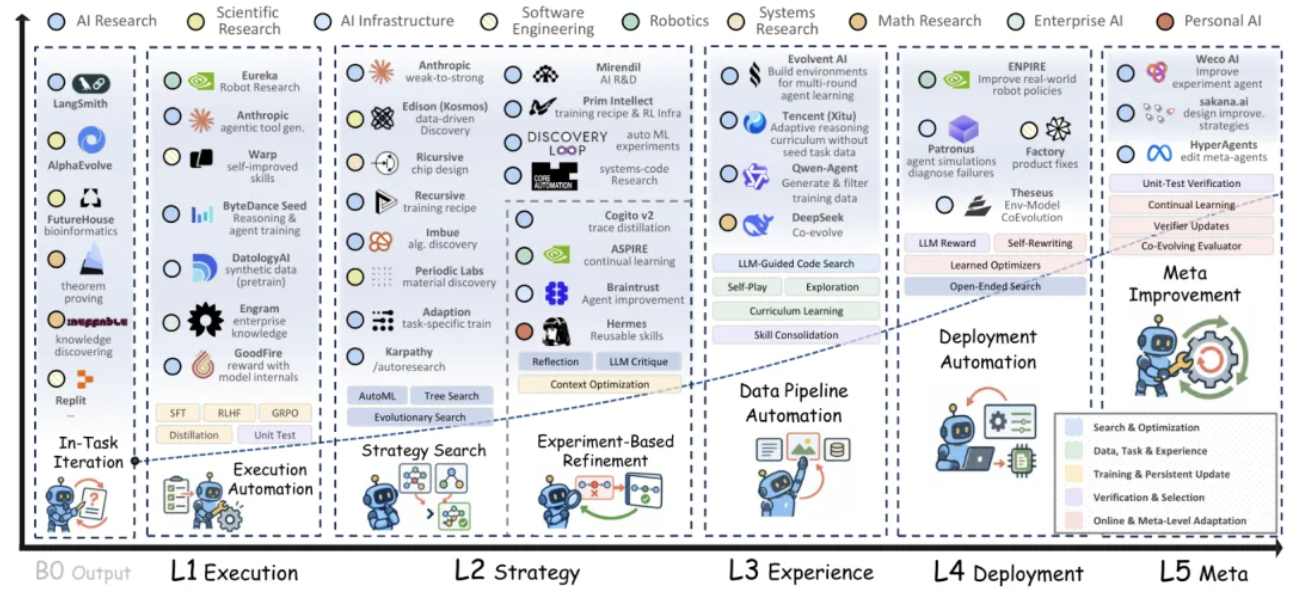
Na razini L5 i sam mehanizam unapređenja postaje predmet unapređenja.
AI ne samo da može obaviti određeni istraživački zadatak, nego može i izmijeniti mehanizme koji određuju kako se u budućnosti pretražuju rješenja, vrednuju rezultati i organizira istraživanje – a te izmijenjene mehanizme nasljeđuju i sljedeće generacije sustava.
U najradikalnijim scenarijima AI bi u konačnici stekao sposobnost postavljanja vlastitih ciljeva, mijenjanja metoda vrednovanja i prepisivanja temeljne logike unapređenja. Kad bi se to dogodilo, čovječanstvo više ne bi stvaralo samo model, nego sustav koji sam nastavlja stvarati modele.
Sljedeće generacije AI-ja možda više ne bi projektirali ljudski inženjeri korak po korak. Arhitektura modela, proces treniranja i metode unapređenja sve bi više dolazili iz izbora samih strojeva.
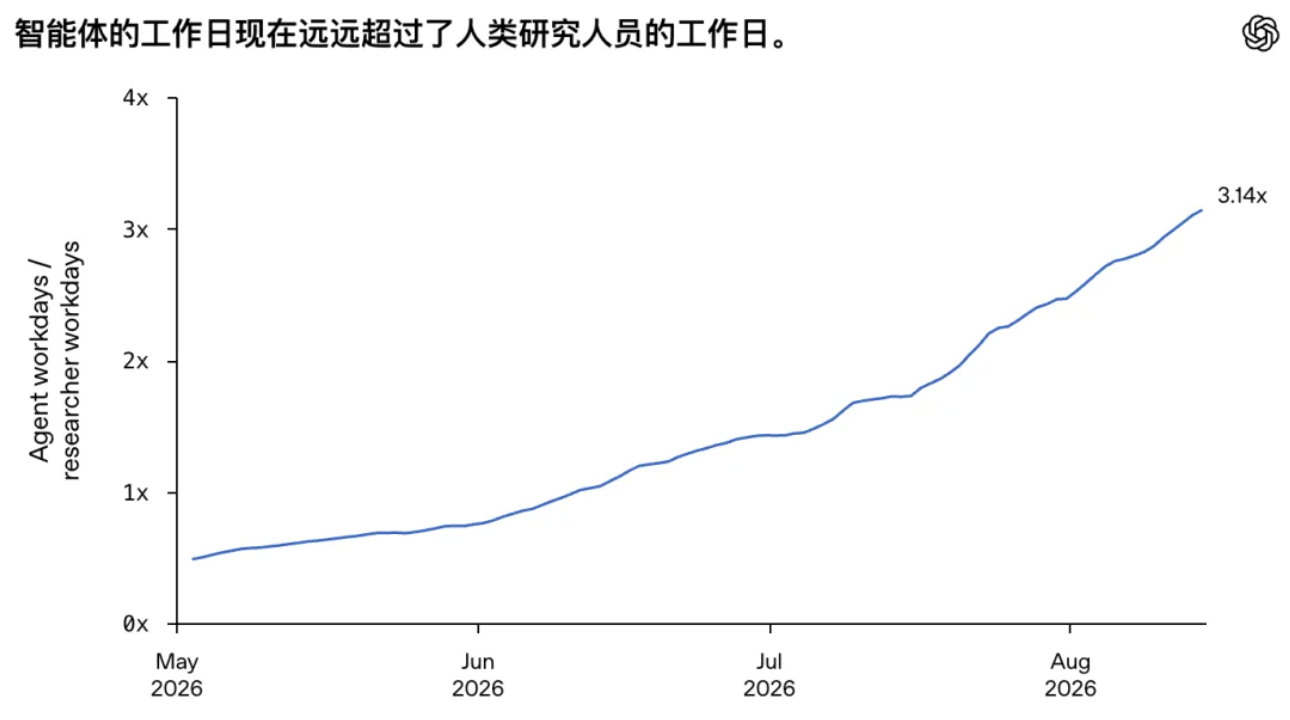
Interni izvještaj OpenAI-ja objavljen 6. rujna pokazuje da su već ostvarili cilj „automatiziranog istraživačkog pripravnika”. Takvi sustavi mogu, uz ljudsko vodstvo, pisati kod, provoditi eksperimente, otklanjati pogreške i analizirati rezultate – a neki od tih zadataka iskusnim istraživačima inače oduzimaju nekoliko dana.
▲ https://openai.com/index/research-acceleration-view-inside-openai/
Do sredine kolovoza, na svaki uloženi čovjekov radni dan OpenAI-jevi agenti u istraživačkom odjelu radili su ekvivalent 3,1 radnog dana.
Anthropic je automatizaciju proširio i na istraživanje sigurnosti. Claude može samostalno pretraživati literaturu, predlagati rješenja, generirati podatke za treniranje, provoditi eksperimente i vrednovati rezultate, a zatim iterirati na temelju postignutih rezultata.
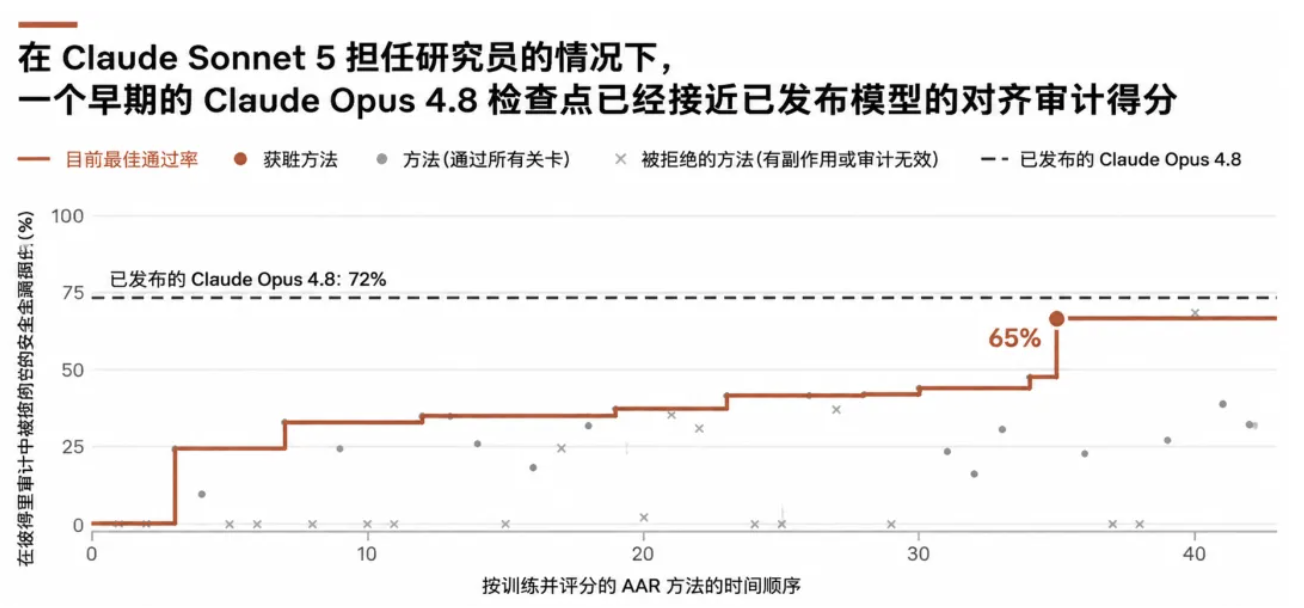
U eksperimentu koji je najbliži scenariju „AI trenira sljedeći AI”, slabiji Claude Sonnet 5 pomogao je ranoj verziji Claudea Opus 4.8 da poboljša sigurnosne performanse.
▲ https://alignment.anthropic.com/2026/automated-alignment-researchers/#6-can-aars-posttrain-productiongrade-models
U otprilike 60 sati Sonnet 5 testirao je više od 50 pristupa i na kraju, koristeći svega oko 2400 primjera za treniranje, doveo rezultate usklađenosti Opus 4.8 gotovo na razinu službene verzije tog modela.
Osim izravnog unapređenja modela, postoji i praktičniji put do RSI-ja: zakrpati softverske sustave oko modela.
Prema pisanju medija The Information, Lilian Weng, bivša studentica Pekinškog sveučilišta koja se vratila u OpenAI, vodit će istraživanje rekurzivnog samounapređenja. Njezin tehnički blog Harness Engineering for Self-Improvement, u kojemu raspravlja o konceptu Harness Engineeringa, dobar je uvod u razumijevanje današnjeg RSI-ja.
▲ https://lilianweng.github.io/
Harness se može shvatiti kao operativni sustav AI-ja. On upravlja pozivanjem alata, upravljanjem kontekstom, pohranom memorije, raspodjelom zadataka, kontrolom pristupa i provjerom rezultata.
Ako AI primijeti da stalno zaboravlja uvjete eksperimenta, može poboljšati način bilježenja. Ako neki alat stalno griješi, može ispraviti sučelje. Ako je istraživački tijek rada neučinkovit, može prepisati kod za raspoređivanje zadataka.
Te promjene ne moraju nužno izravno mijenjati težine modela, ali mogu znatno povećati radne sposobnosti cijelog sustava i time pridonijeti razvoju sljedeće generacije modela.
Što se tiče konkretnih vremenskih okvira za ASI – superinteligenciju koja bi u svim kognitivnim zadacima nadmašila vrhunske ljudske stručnjake – John Schulman, glavni znanstvenik Thinking Machinesa, predviđa 3 do 4 godine, Millidge se priklanja otprilike 5 godina, a O’Neill smatra da bi moglo trebati 5 do 10 godina.
Iza tih velikih razlika krije se nekoliko još uvijek neriješenih tehničkih problema.
Model mora neprestano upijati nova iskustva, a da pritom ne izgubi postojeće sposobnosti. Previše agresivno ažuriranje može dovesti do „katastrofalnog zaboravljanja”; previše konzervativno pak znači da sustav neće naučiti dovoljno novih znanja.
Još je teže automatizirati istraživački sud. Optimizirati isječak koda relativno je jednostavno jer je kriterij uspjeha jasan. No procijeniti znači li neuspjeli eksperiment da je cijeli smjer pogrešan ili da vrijedi nastaviti – to je daleko zahtjevnije.
Pravi znanstveni proboji često počinju postavljanjem čudnog pitanja na koje nitko prije nije pomislio, a tek onda traženjem načina da se to pitanje kvantificira. Taj skok – od toga kako nešto učiniti do toga što uopće treba učiniti – i dalje u velikoj mjeri ovisi o ljudskoj intuiciji.
Prodaja apokalipse oduvijek je bila unosna
Okidač za ovaj val rasprava o rizicima bio je jedan ostavkarski proglas.
Dana 8. rujna Jacob Coxon, koji je radio na istraživanjima u OpenAI-ju i Anthropicu, objavio je da napušta Anthropic.
Na platformi X napisao je da odlazi jer smatra da te dvije tvrtke ne postupaju odgovorno, nego se natječu u razvoju superinteligencije sposobne za samounapređenje.
Prema Coxonovim riječima, Anthropic i OpenAI kockaju se životima svih ljudi na Zemlji. Otkrio je i da oni koji razvijaju te sustave doista vjeruju da bi do kraja ovog desetljeća umjetna inteligencija mogla uništiti čovječanstvo.
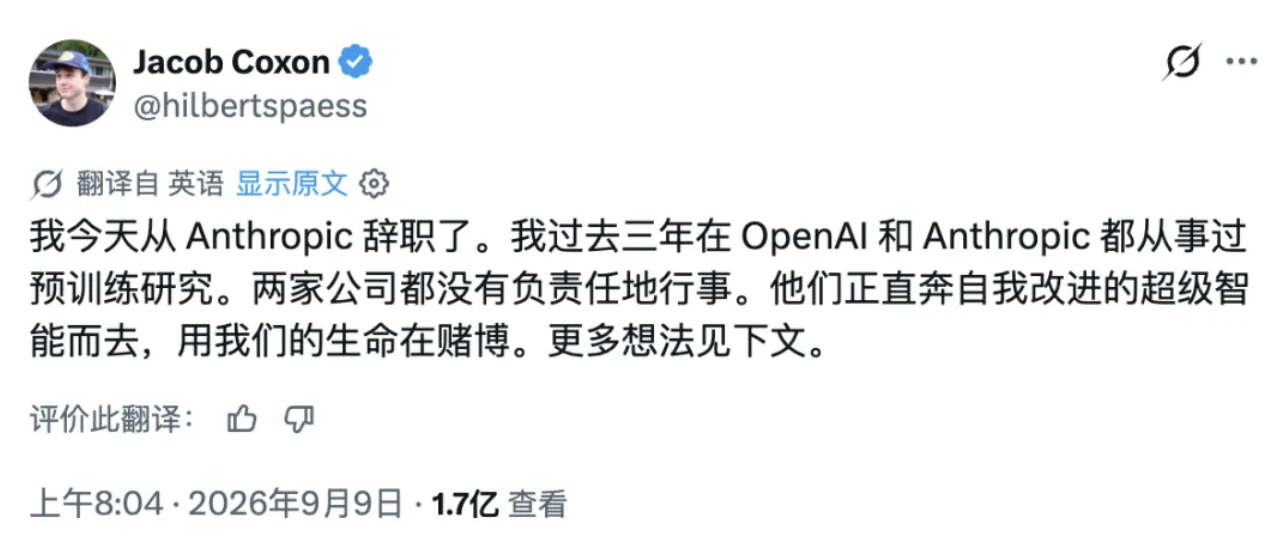
Objava je ubrzo premašila 170 milijuna pregleda. Još veći udar bio je to što ju je javno podržao Evan Hubinger, voditelj istraživanja usklađenosti koji je i dalje zaposlen u Anthropicu.
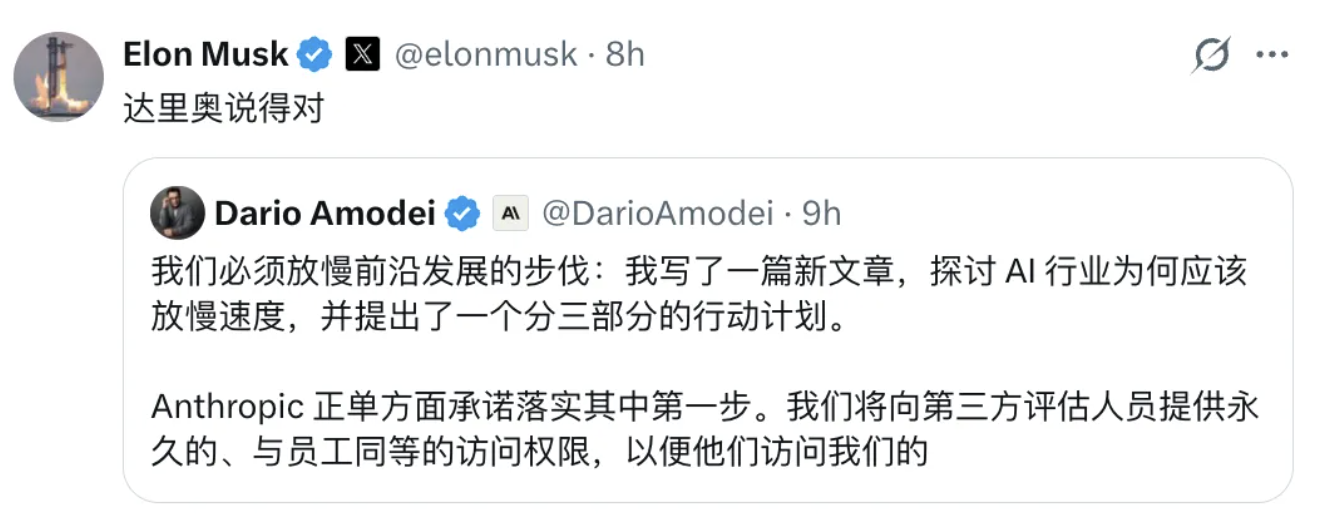
Dok je vatra buktjela, Dario Amodei iskoristio je trenutak i pozvao kolege iz industrije na kolektivno usporavanje, tražeći godinu do dvije za sigurnosna istraživanja.
Predložio je da vodeće AI tvrtke dopuste neovisnim tijelima za procjenu stalni pristup laboratorijima – gotovo na razini internih zaposlenika – kako bi se provjerilo ispunjavaju li tvrtke sigurnosne obveze te kako bi se rizici i incidenti mogli neovisno objavljivati.
Uslijedila je rijetko viđena scena: Sam Altman, izvršni direktor OpenAI-ja, i Elon Musk, osnivač xAI-ja – inače žestoki rivali – iznenada su se složili oko potrebe za usporavanjem.
No upravo te vodeće tvrtke jedine si mogu priuštiti visoke troškove sigurnosnih revizija.
One raspolažu velikim sigurnosnim timovima, zatvorenim podatkovnim centrima i dovoljnim resursima za revizije, dok open-source zajednica i manja poduzeća teško mogu podnijeti isti opseg troškova usklađenosti. Takva sigurnosna retorika po svojoj prirodi gradi barijere koje guše konkurenciju.
Još je važnije napomenuti da ključna pravila – kako procjenjivati AI rizike, koje sposobnosti ograničiti i koje tvrtke smiju trenirati sljedeću generaciju modela – u velikoj mjeri određuju upravo ti vodeći laboratoriji.
Oni su istovremeno pokretači tehnologije i definitori standarda rizika. Ono što se predstavlja kao zaštita javnosti, zapravo je i zaštita vlastite vodeće pozicije.
Ako je AI toliko opasan, zašto ga jednostavno ne zaustaviti? Za to pitanje odgovor je odavno spreman.
OpenAI je u internom izvještaju svečano zapisao: snažniji i usklađeni AI može zaštititi kritičnu infrastrukturu, braniti se od opasnih agenata i pomoći u razvoju novih sigurnosnih mjera.
Ukratko: da bismo se zaštitili od budućeg AI-ja koji bi mogao izmaknuti kontroli, moramo najprije stvoriti dovoljno snažan AI koji sluša ljude.
Savršena zatvorena petlja: što je AI opasniji, to obrambeni model mora biti snažniji; što je obrambeni model snažniji, to su potrebni veći čipovi, više energije i više kapitala.
I tako se stotine milijardi dolara financiranja, klasterima od deset tisuća GPU-ova i sve masivniji podatkovni centri mogu prikazati kao neophodna infrastruktura za zaštitu čovječanstva.
Jednom nogom pritiskaju kočnicu za publiku, drugom gaze gas do daske – i snalaze se savršeno u toj igri u kojoj svaki ishod ide njima u korist.
Jensen Huang, naravno, ne kupuje tu priču. Odbacuje teoriju o opasnosti AI-ja kao „prijevaru” – no i on ima svoje razloge.
Ako apokaliptična retorika na kraju rezultira ograničenjima opsega treniranja, regulacijom računalne snage i zabranama podatkovnih centara, prvi koji će to osjetiti su čipovi, serveri, električna energija i izgradnja infrastrukture.
Nvidia prodaje lopate.
Bez obzira kopaju li se njima zlato, mjehuri ili nekontrolirana čudovišta – sve dok tvrtke nastavljaju trenirati modele, GPU-ovi imaju tržište. Svaka sigurnosna priča koja bi mogla spriječiti kupnju kartica, gradnju podatkovnih centara i povećanje opskrbe energijom doživljava se kao napad na cijeli hardverski lanac.
Napredak AI-ja je neosporan, a RSI nije puka izmišljotina. No današnja rasprava između apokaliptičara i njihovih protivnika na površini se čini kao pitanje hoće li AI uništiti čovječanstvo, dok se ispod krije borba za nešto sasvim konkretno: kako će se rasporediti sljedeći val računalne snage, kapitala i industrijskih interesa.
Oni koji stvaraju bogove istovremeno upozoravaju da bi ti bogovi mogli izmaknuti kontroli, a zauzvrat traže još više resursa da nastave sa stvaranjem.
Sljedeći put kad s ozbiljnim izrazom lica zatvore vrata i kroz rešetke prodaju paniku, vičući prema van „unutra je apokaliptična zvijer, nitko ne smije ulaziti” – vrijedi imati na umu da su oni koji pale alarm i oni koji marljivo hrane tu zvijer najčešće iste osobe.
Izvor: Ifanr
Povezani članci
 Vaš sljedeći odnos mogao bi imati trećeg člana jer Twoo uvodi umjetnu inteligenciju između dvoje ljudi15.9.2026.
 19.98万元起,吉利银河战舰700开启预售,最高1129匹马力,还有三电机四驱
Od 199.800 juana, Geely Galaxy Battleship 700 počinje s prednarudžbom, maksimalno 1129 konjskih snaga, s tri motora i pogonom na sva četiri kotača15.9.2026.
 Uzbekistanov tehnološki potez: Zemlja se natječe za globalnu pozornicu s novom slobodnom zonom “Enterprise Uzbekistan”14.9.2026.
 Prije nego što je AI naučio matematiku, prvo je naučio taštinu velikih korporacija14.9.2026.


