


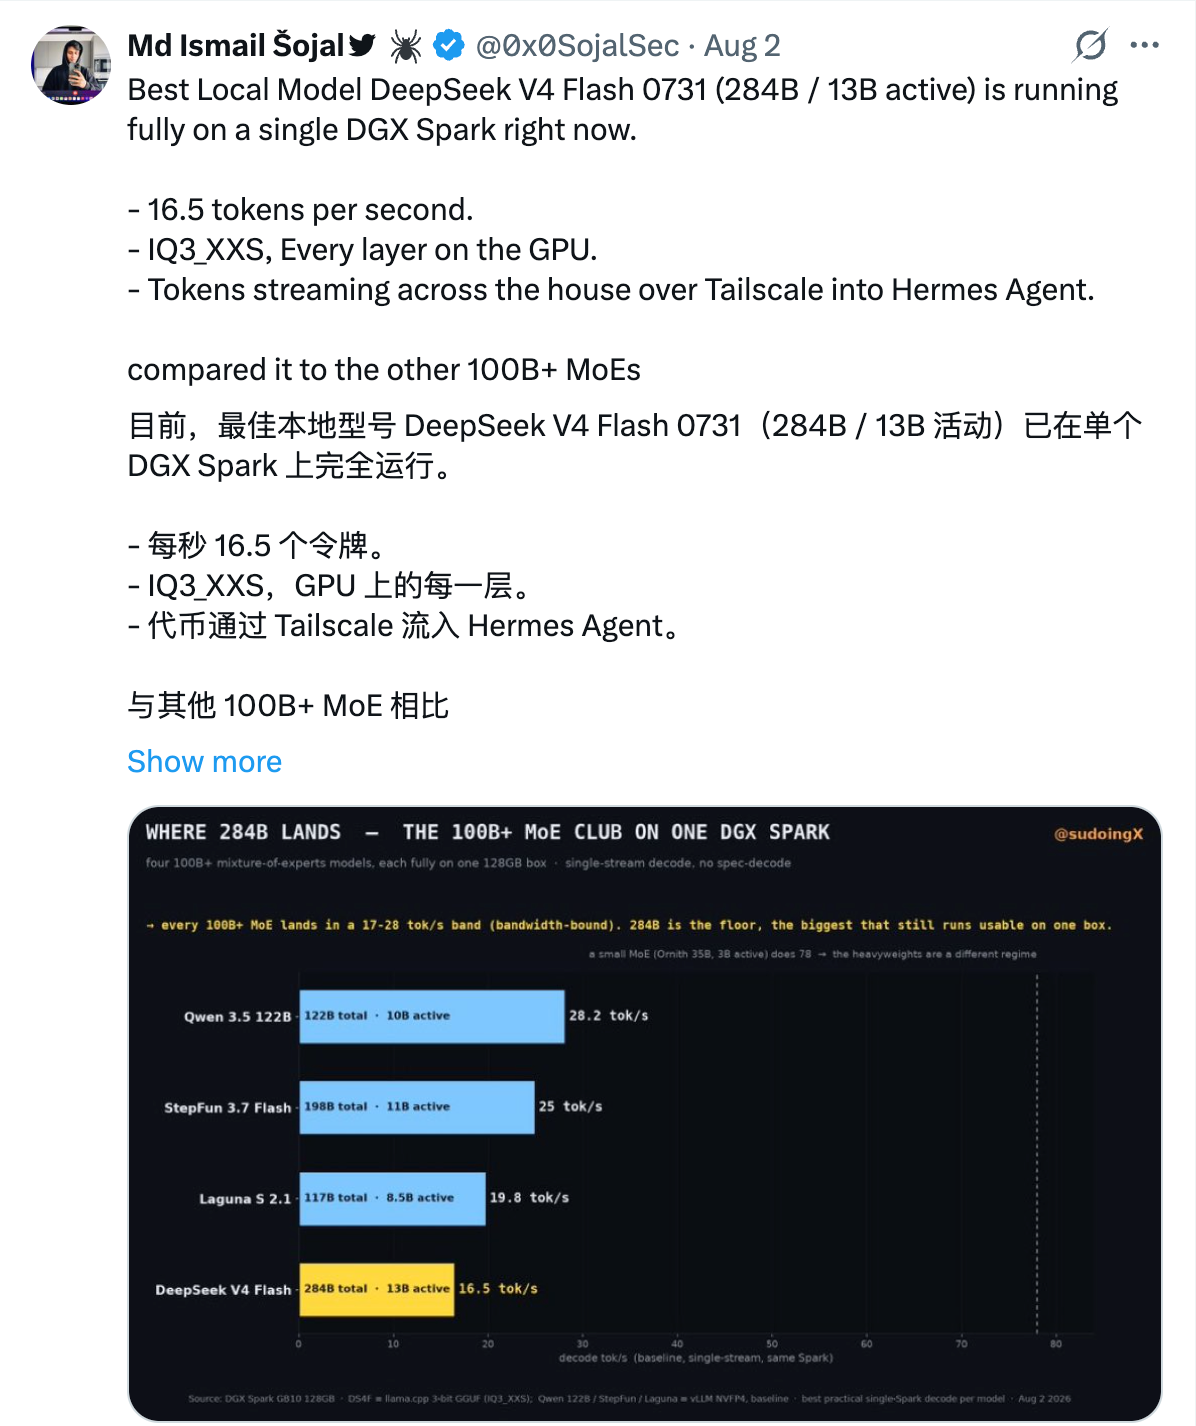
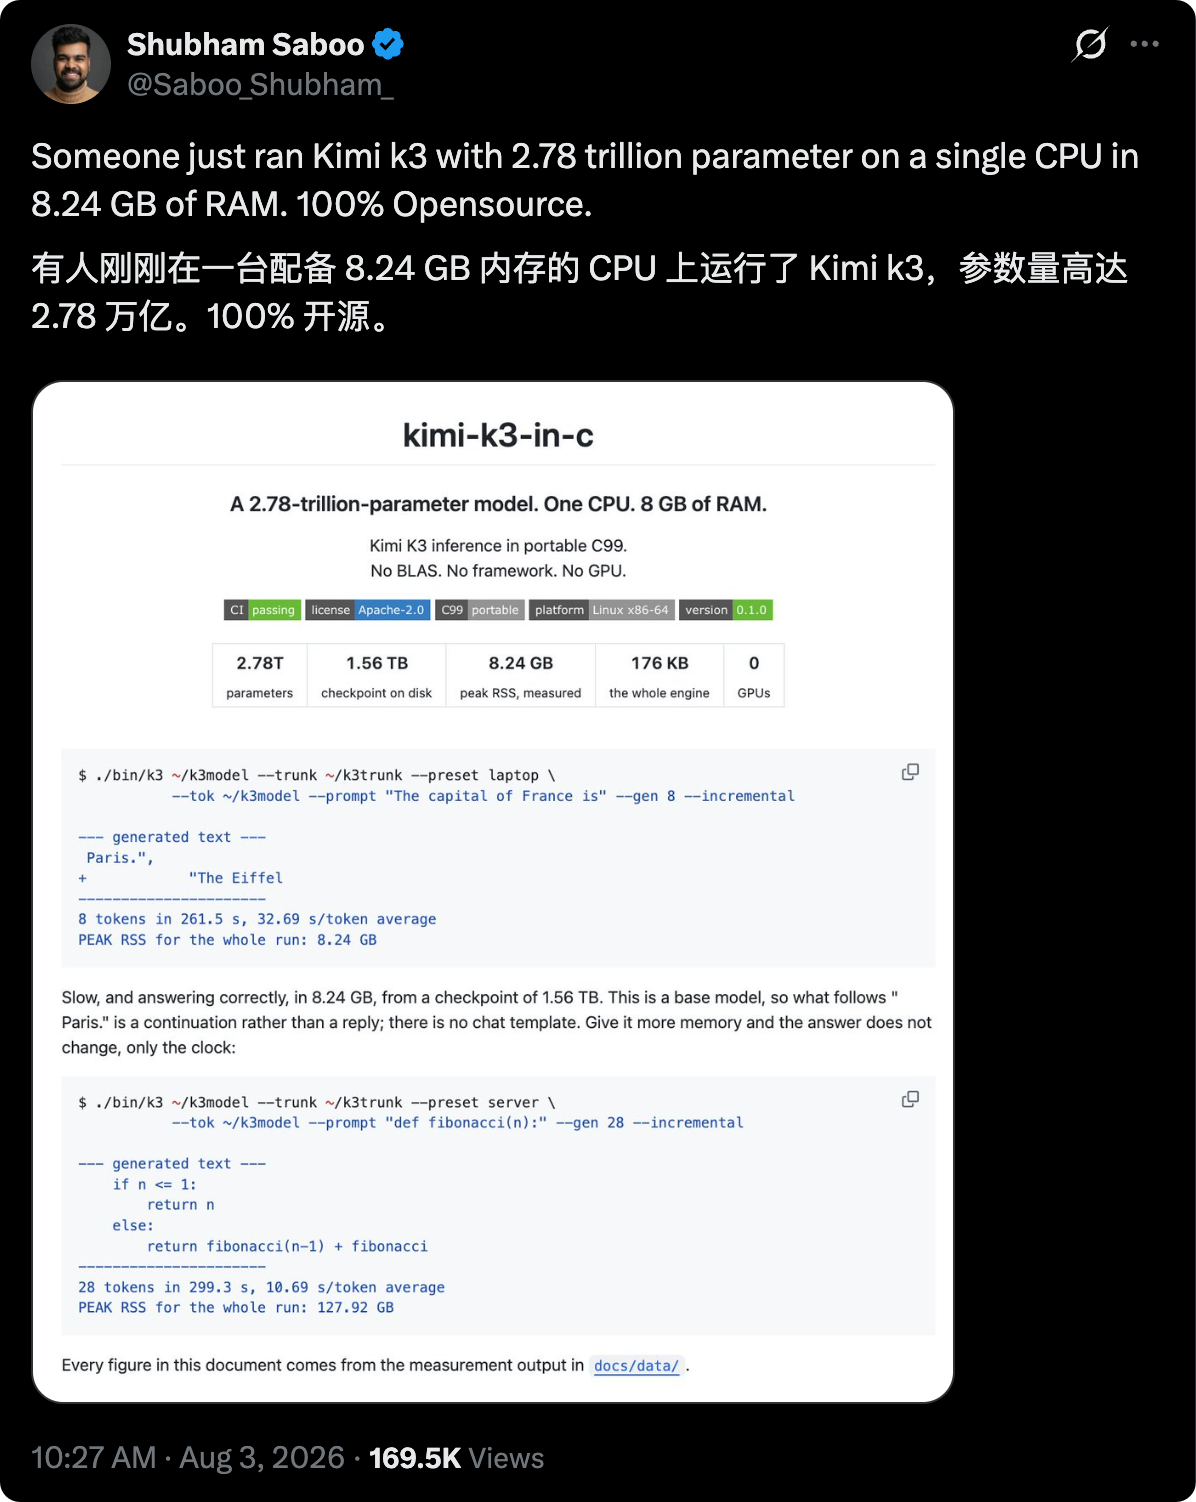
CPU s 8,24 GB RAM-a, jezični model s 2,78 bilijuna parametara, bez grafičke kartice — i Kimi K3 jednostavno radi.
A puna verzija DeepSeek V4 Flash može se pokrenuti na Nvidijinom DGX Sparku ili na Macu s 128 GB RAM-a.
Od početka 2025., kada je DeepSeek R1 izazvao pravu pomamu za lokalnim pokretanjem modela, internet je bio prepun vodiča koji su objašnjavali kako zaobići poruku „server je zauzet, pokušajte kasnije” i postaviti vlastiti DeepSeek R1 na kućnom računalu bez ikakvih ograničenja.
Danas su se parametri velikih jezičnih modela popeli s razine stotina milijardi na bilijune — R1 s 671 milijardi parametara izgleda skromno u usporedbi s Kimi K3 koji ima 2,78 bilijuna ili Qwen3.8-Max s 2,4 bilijuna.

DeepSeek V4 Flash, brža verzija za svakodnevnu upotrebu, zadržava 284 milijarde parametara, no preview verzija V4 Pro dostiže ukupno 1,6 bilijuna.
Na hardverskoj strani stvari su se jednako promijenile: cijene RAM-a su porasle, lokalni Agent alati su eksplodirali u popularnosti, Mac Mini je nestao s polica, Apple je podigao početne cijene Mac uređaja, a DGX Spark koji je Jensen Huang predstavio krajem prošle godine poskupio je s preporučenih 3.999 dolara na 4.699 dolara.
U svijetu AI-ja jedan dan vrijedi godinu dana. Vodiči za lokalno pokretanje modela koji su bili aktualni tada, danas zahtijevaju potpuno novi pristup u eri bilijunskih parametara.
Kako 2026. godine postaviti lokalni jezični model? Kakav hardver je potreban? Koji radni tok ima smisla za vlastito pokretanje modela? I koji model odabrati? Sve to objašnjavamo u ovom tekstu.
Kratki sažetak za one koji žure
Kimi K3 radi na 8 GB RAM-a, ali zahtijeva 1,7 TB SSD-a i čeka se pola minute po tokenu.
Pri lokalnom pokretanju modela, kapacitet VRAM-a je na prvom mjestu, a tek onda propusnost memorije.
8 GB VRAM-a odgovara modelima od 4B do 7B; 16 GB pokriva 9B do 14B; 24 GB ulazi u rang 24B do 27B; modeli od 120B obično zahtijevaju 80 GB VRAM-a ili veliku jedinstvenu memoriju.
Kako je Kimi K3 uopće uspio raditi
Unesite „The capital of France is”, program ispiše „Paris”.
GitHub projekt pod nazivom kimi-k3-in-c, napisan u manje od 200 KB C koda, izvodi zaključivanje Kimi K3 modela isključivo na CPU-u. Bez PyTorcha, bez CUDA-e — cijeli program ovisi samo o kompajleru, OpenMP-u i sistemskim matematičkim bibliotekama.
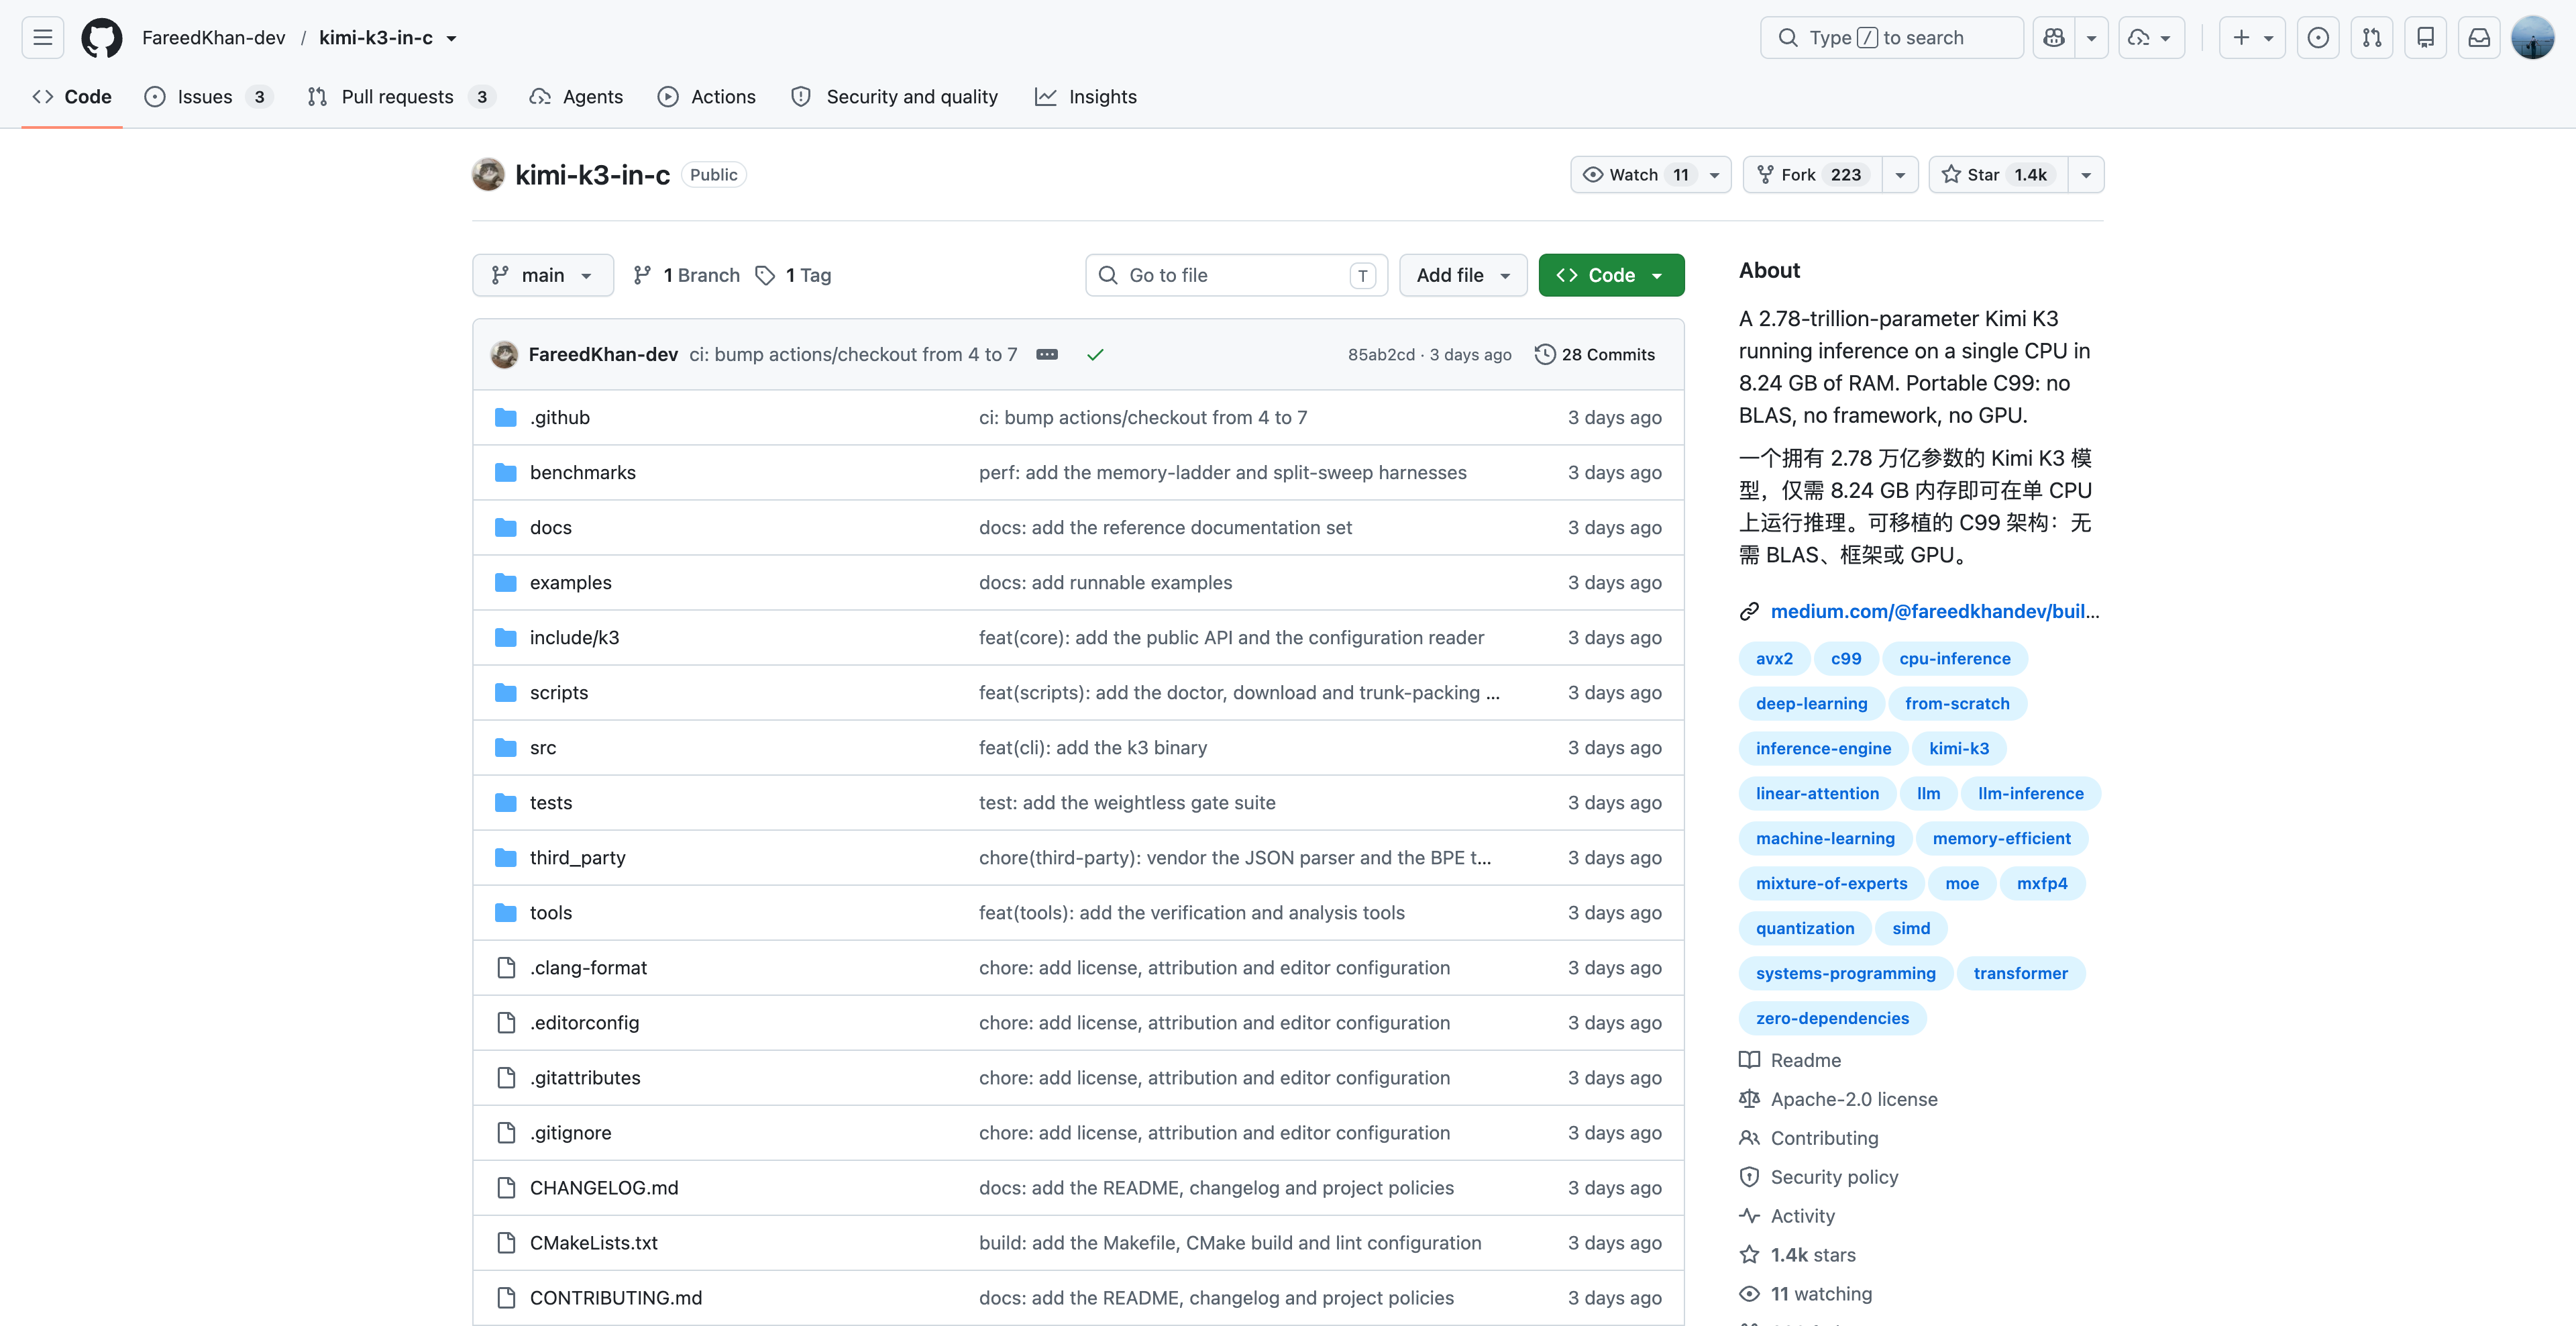
No 2,78 bilijuna parametara nije zaista smješteno u tih 8 GB RAM-a. Kompletne težine i dalje zauzimaju oko 1,56 TB na disku; projekt je zapravo smanjio samo onaj dio modela koji mora u svakom trenutku ostati u memoriji.
Ukratko, programer je ostatak težina modela pohranio na SSD. Prema službenoj kartici modela Kimi K3, model ima 2,8 bilijuna parametara, ali pri obradi svakog tokena aktivira se samo oko 104 milijarde — svega 3,7% od ukupnog broja.
Kimi K3 ima ukupno 93 sloja, od kojih 92 koriste MoE arhitekturu. Svaki sloj raspolaže s 896 različitih stručnjaka (eksperata), a usmjerivač za svaki token odabire 16 koji sudjeluju u izračunu.
Preostalih 880 stručnjaka u toj rundi uopće nije potrebno.

Budući da se po sloju koristi samo 16 stručnjaka, program ih prema rezultatu usmjerivača jednostavno učitava s diska. No čak i kad su težine stručnjaka na disku, model još uvijek ima 113,49 GB gustih težina koje se ne mogu zaobići.
Tu spadaju slojevi pažnje, usmjerivači, normalizacija, dijeljeni stručnjaci, Embedding i izlazni sloj. Gotovo svaki token zahtijeva njihovo sudjelovanje, pa ih uobičajeni MoE pristupi s preuzimanjem na disk u potpunosti drže u memoriji.
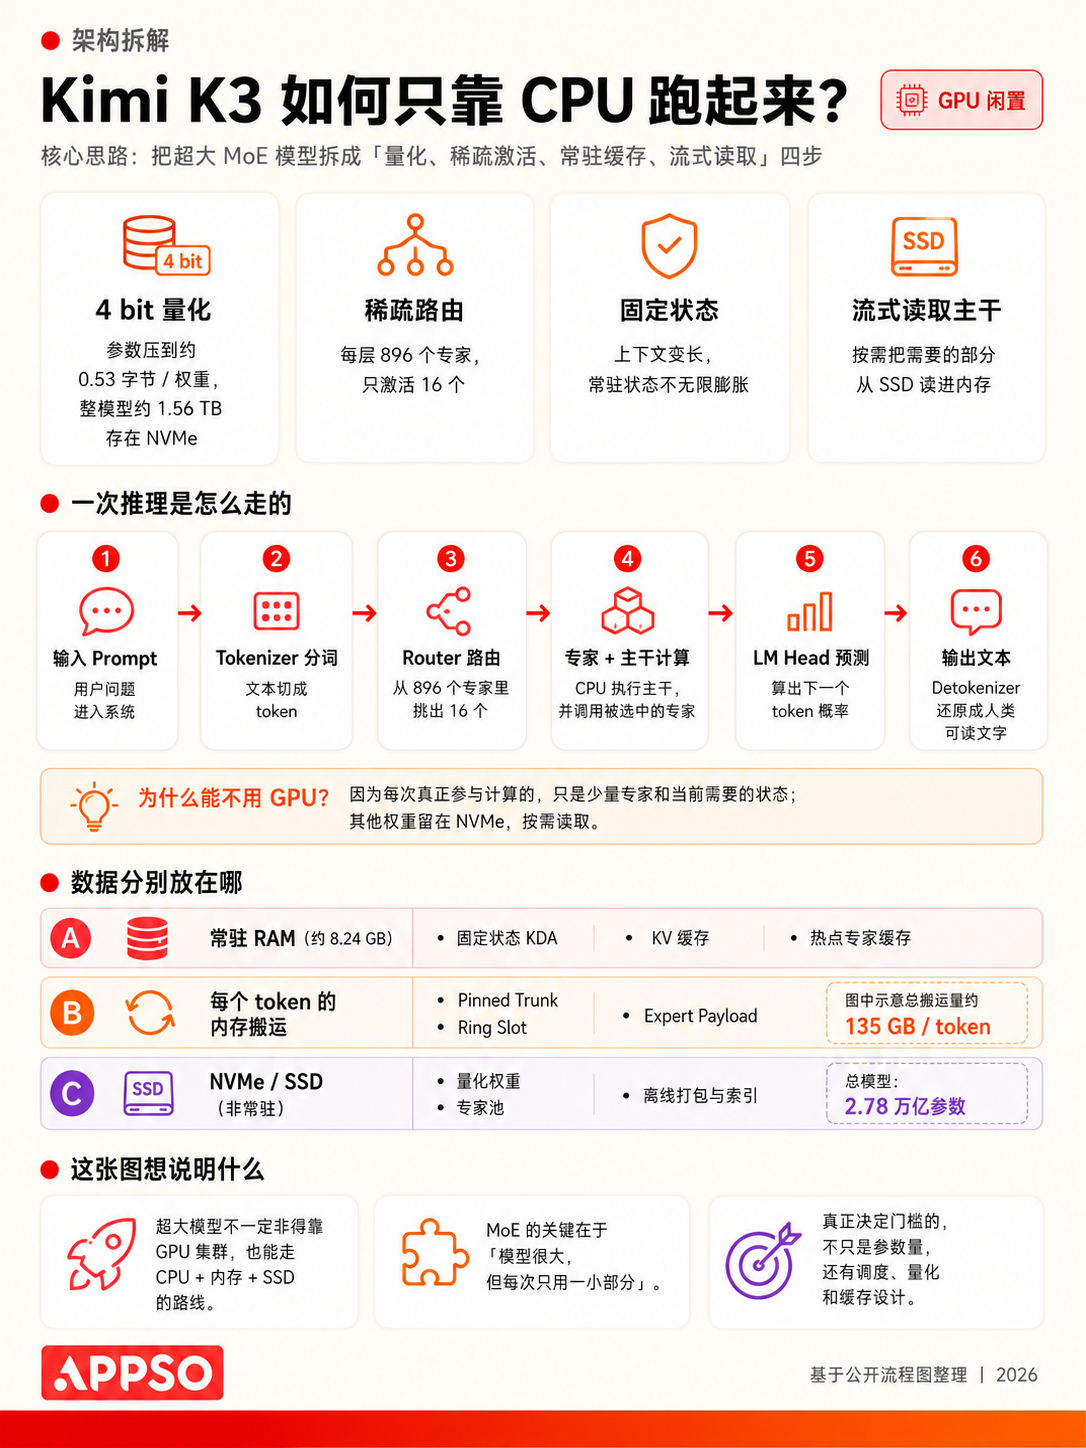
kimi-k3-in-c uvodi još jednu razinu strujne obrade: izvorne težine Kimi K3 raspoređene su u 96 datoteka, a težine istog sloja razbacane su po ogromnim fragmentima. Projekt najprije pokreće skriptu za pakiranje koja 93 sloja gustih težina reorganizira u jednu kontinuiranu datoteku od oko 109 GB, pri čemu svaki sloj ima fiksnu poziciju na disku.
Kada počne zaključivanje, program prema memorijskom budžetu fiksira što više slojeva može. Ono što ne stane, obrađuje se kroz kružni međuspremnik sloj po sloj: trenutni sloj se učita, izračun se završi, međuspremnik se oslobodi i prepisuje sljedećim slojem.
Na kraju, cijeli proces smanjenja memorije svodi se na četiri broja:
5,56 TB: teorijska veličina svih parametara u BF16 formatu;
1,56 TB: službeno objavljene MXFP4 težine;
113,49 GB: dio koji mora stalno sudjelovati u izračunu, nakon što su težine stručnjaka premještene na disk;
8,24 GB: izmjerena vršna memorija nakon što se i gusti dio okosnице počne učitavati sloj po sloj.

Uvelike je pomoglo i 69 KDA slojeva u Kimi K3. KDA ne mora za svaki prethodni token čuvati potpuni KV Cache — umjesto toga održava rekurzivno stanje fiksne veličine. Preostalih 24 MLA sloja pak komprimira predmemoriju pažnje putem niskodimenzionalnih reprezentacija.
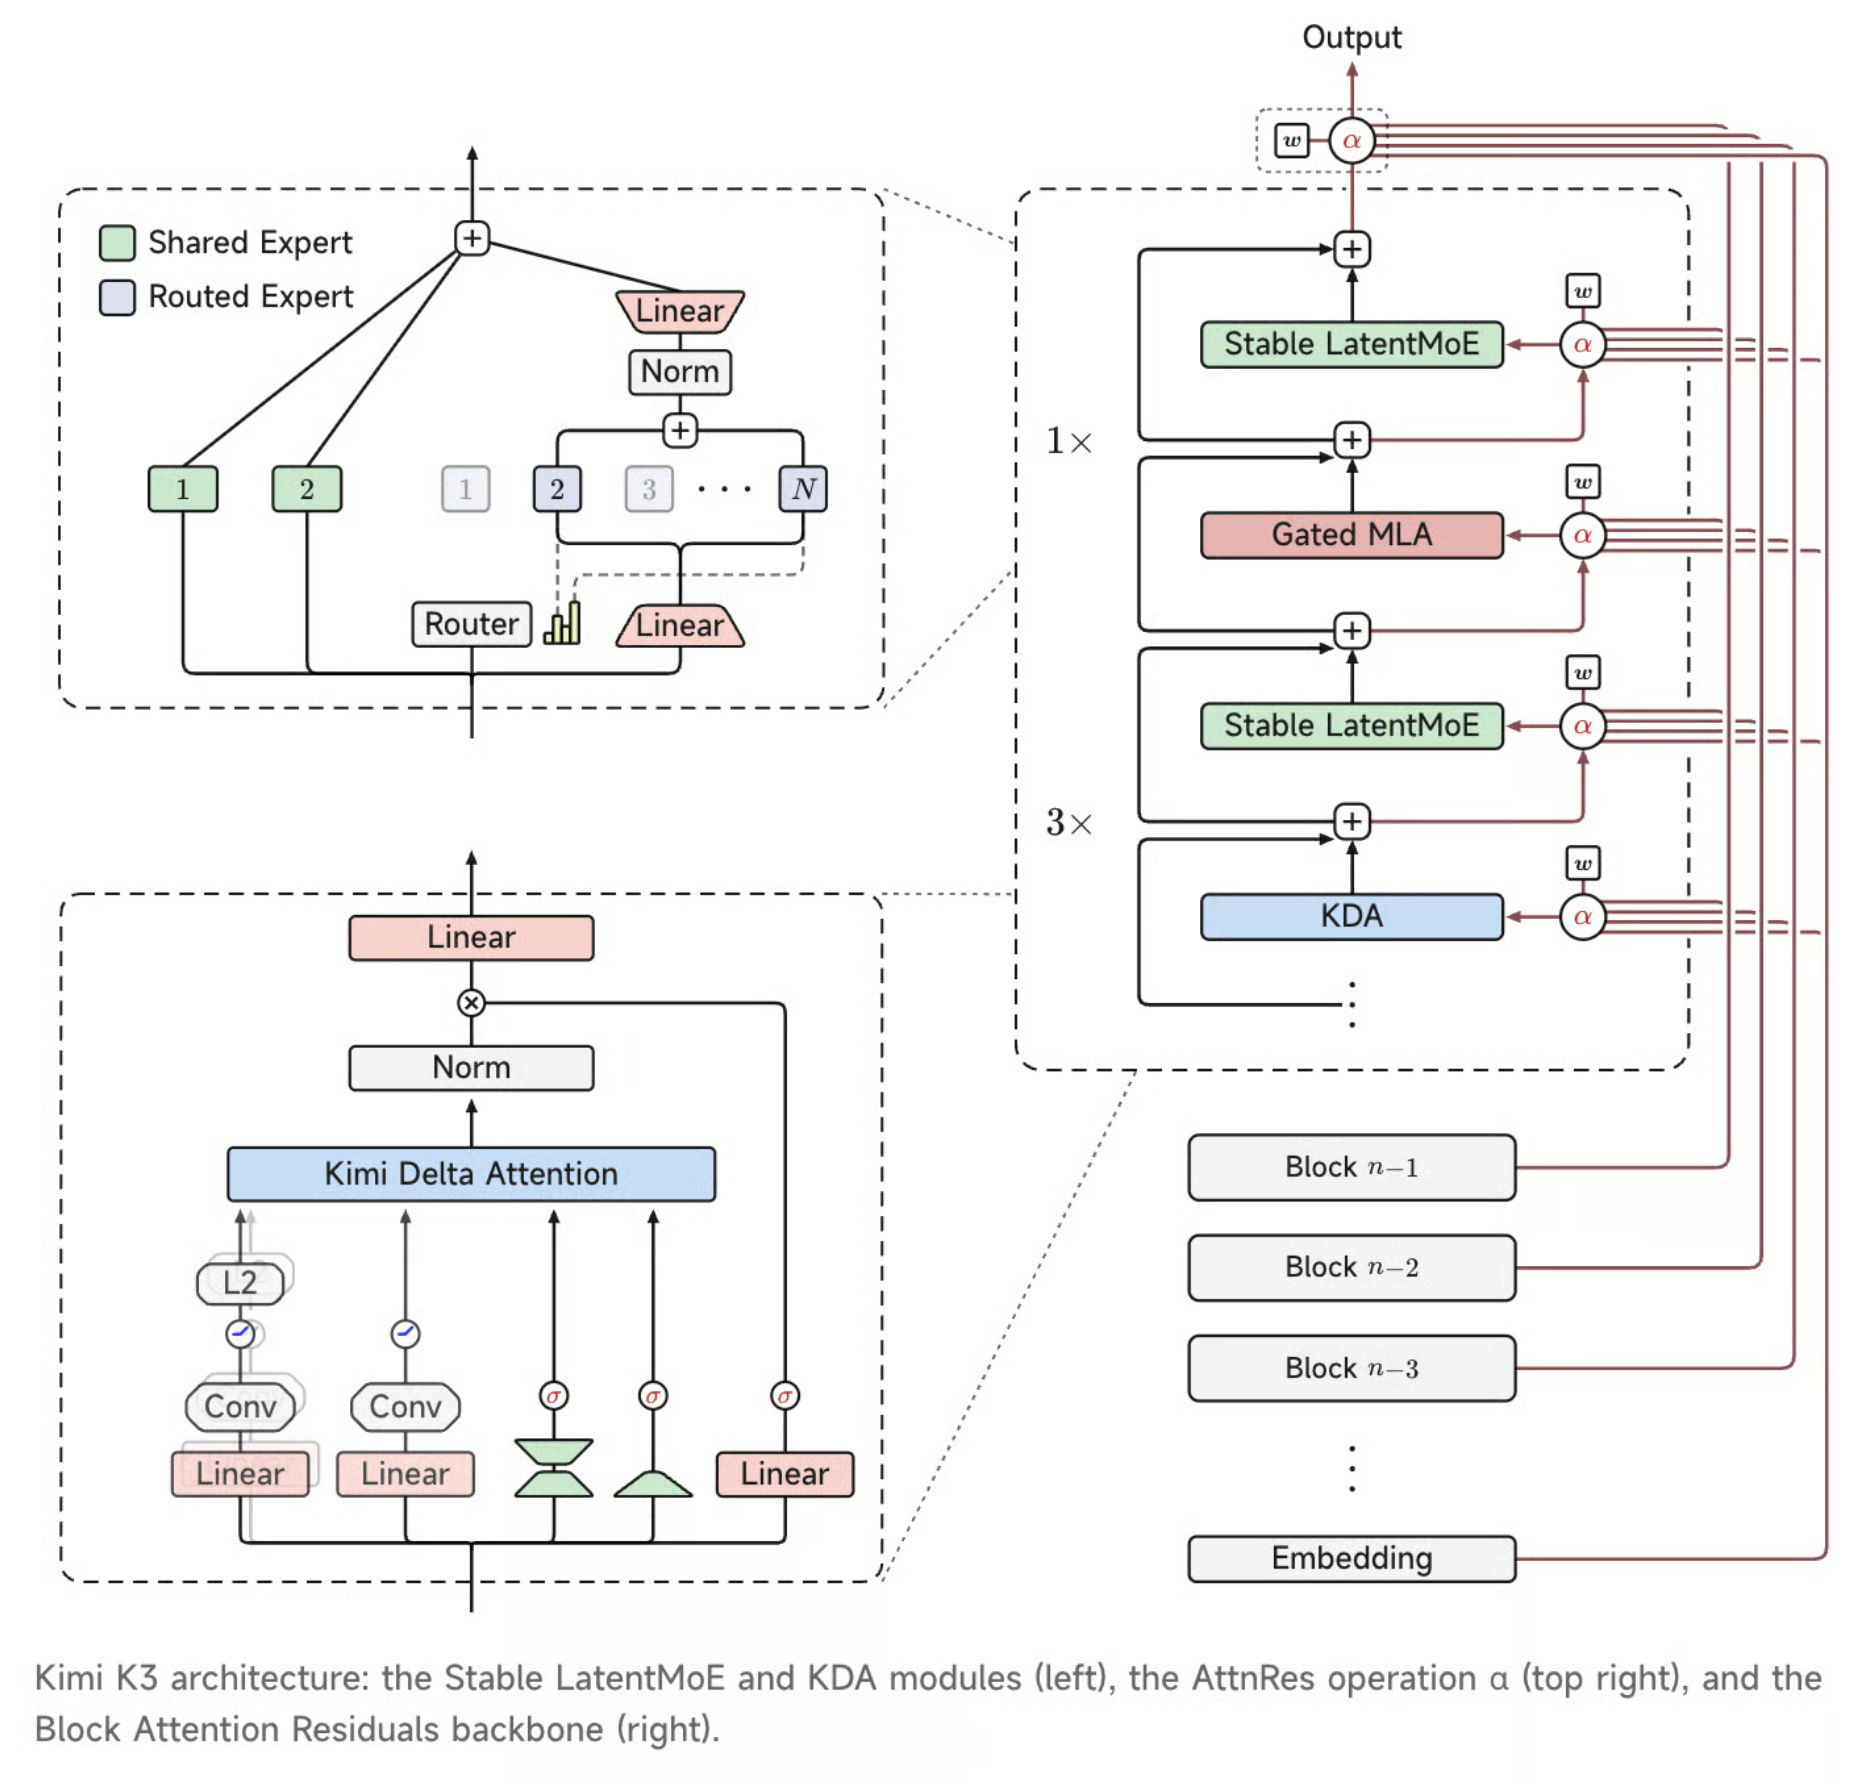
▲ Arhitektura Kimi K3; KDA je Kimi Delta Attention, vrsta mehanizma pažnje
U kombinaciji s inkrementalnim dekodiranjem — gdje se u prvoj rundi obrađuje cijeli prompt, a u svakoj sljedećoj samo novoizgenerirani token — memorija ne raste nekontrolirano s duljinom generiranja, pa program može više prostora posvetiti raspoređivanju težina.
Cijena 8 GB: pola minute čekanja po tokenu
8 tokena ukupno je trajalo 261,5 sekundi. Memorijska upotreba spuštena je na 8,24 GB, ali stvarni trošak premješten je na disk i vrijeme.
U konfiguraciji s minimalnom memorijom, Kimi K3 za svaki generirani token mora pročitati oko 25,83 GB težina stručnjaka. Budući da nema prostora za fiksiranje gustih slojeva, i oko 108,81 GB težina okosnice mora se iznova skenirati.
To znači da jedan token može zahtijevati premještanje više od 130 GB podataka s diska.

Autor je izmjerio da je u konfiguraciji s 8 GB prosječno trebalo 32,69 sekundi za generiranje jednog tokena, što odgovara brzini od oko 0,03 tokena u sekundi. Za 8 tokena iza rečenice „The capital of France is” trebalo je ukupno više od četiri minute.
U drugom testu s jednakim uvjetima, memorija je povećavana od 8 GB do 224 GB — 28 puta više — a brzina je porasla samo oko 1,7 puta. Kroz cijelo izvođenje, između 40 i 60 posto vremena odlazilo je na čekanje diska.
Ključni hardver u ovoj shemi više nije GPU, nego NVMe. Obični mehanički diskovi teško podnose takvo nasumično čitanje, a mrežna pohrana dodatno usporava rad. Projekt zahtijeva najmanje oko 1,7 TB slobodnog prostora za 1,56 TB izvornih težina i reorganiziranu datoteku okosnice od 109 GB.
Ako disk može stabilno čitati samo 1 GB u sekundi, samo premještanje podataka za jedan token moglo bi trajati više od dvije minute.

Najupečatljiviji opis cijelog projekta — „One CPU, 8GB RAM” na naslovnoj stranici — zahtijeva ipak malo konteksta. Svi autorovi podaci potječu s radne stanice s dva AMD EPYC 7763 procesora, ukupno 124 CPU jezgre, 228 GB RAM-a i 3,2 TB NVMe SSD-a. Na stroju su bile instalirane i četiri NVIDIA L40 kartice, no u testiranju nisu korištene.
Tih 8 GB znači da je autor putem Linux cgroup mehanizma (alat za upravljanje resursima u Linuxu) ograničio proces na 8 GB memorije, nakon čega je izmjerio vršni RSS (Resident Set Size — stvarna fizička memorija koju proces zauzima) od 8,24 GB.
Time je dokazano da zaključivački mehanizam može završiti izračun unutar tog memorijskog budžeta, ali test nije proveden na stvarnom laptopu s 8 GB RAM-a.
Možda je „One CPU” točnije razumjeti kao „samo CPU”. Između 124 serverskih jezgri i procesora u prosječnom laptopu i dalje zjapi golema razlika u računalnoj snazi.
Premda cijeli eksperiment na kraju djeluje pomalo kao marketinški trik — jer ne može zaista pretvoriti stari laptop u potpuni Kimi K3, niti zamijeniti postojeće API usluge — neki korisnici s pravom primjećuju da je projekt, gledano s inženjerske strane, odrađen vrlo ozbiljno.
Uz to, dokazuje jednu važnu stvar: ukupan broj parametara modela više se ne može izjednačiti s memorijskim pragom potrebnim za pokretanje.
Što onda može računalo s 8 GB RAM-a
Da biste odabrali pravi hardver, morate razumjeti dva ključna uska grla lokalnog pokretanja modela: kapacitet VRAM-a i propusnost memorije.
Što se tiče VRAM-a, potrebna količina nije samo veličina težina modela — treba rezervirati i prostor za KV Cache (predmemoriju konteksta) i aktivacijske vrijednosti: težine modela (GB) ≈ broj parametara (B) × broj bita kvantizacije ÷ 8 × 1,15. Ukupna potrebna memorija ≈ težine modela + KV Cache + 1–3 GB radnog međuspremnika.

Konkretno: FP16 (puna preciznost bez gubitaka) — 1B parametara zahtijeva oko 2 GB VRAM-a. INT8 (8-bitna kvantizacija) — 1B parametara zahtijeva oko 1 GB. INT4/Q4_K_M (4-bitna kvantizacija, najčešći izbor) — 1B parametara zahtijeva oko 0,5–0,6 GB.
Kod MoE modela poput DeepSeek V4 ili Kimi, pri zaključivanju se aktivira samo dio stručnjaka, ali sve težine stručnjaka moraju biti u potpunosti učitane u memoriju ili VRAM.
Prema Q4 kvantizaciji i kontekstu od 8K do 16K tokena, okvirna veza između dostupnog VRAM-a i odgovarajuće veličine modela izgleda otprilike ovako:

Konkretno za grafičke kartice: RTX 5060 Ti s 16 GB VRAM-a košta oko 5.100–5.300 kuna i odgovara modelima od 9B do 14B; rabljeni RTX 3090 s 24 GB kreće se od 5.000 do 8.000 kuna i ulazi u rang 24B do 27B, ali nosi rizike potrošnje od 350 W, rudarskog porijekla i mogućih problema s VRAM-om.
Ako je model u potpunosti smješten u grafičku karticu, 6 do 8 modernih CPU jezgri obično je dovoljno. Uz grafičke kartice od 8 do 16 GB preporučuje se 32 GB sistemske memorije, uz 24 do 32 GB VRAM-a — 64 GB; za pokretanje modela od 70B putem hibridnog preuzimanja na disk potrebno je 128 GB RAM-a.
Što se hardvera tiče, grafička kartica je ono što najviše utječe na performanse — memorija, CPU i disk trebaju samo biti dovoljno dobri. Ipak, za disk je preporučljivo krenuti od 1 TB SSD-a, a za dugoročnu upotrebu bolje je uzeti 2 TB.
Bez zasebne grafičke kartice, vrijedi razmotriti uređaje s velikom jedinstvenom memorijom poput Mac Studia, Ryzen AI Max+ 395 ili DGX Sparka. S 96 do 128 GB memorije mogu primiti modele od 70B, 109B, pa i neke Q4 modele od 120B — uz višu cijenu i ograničene mogućnosti nadogradnje.
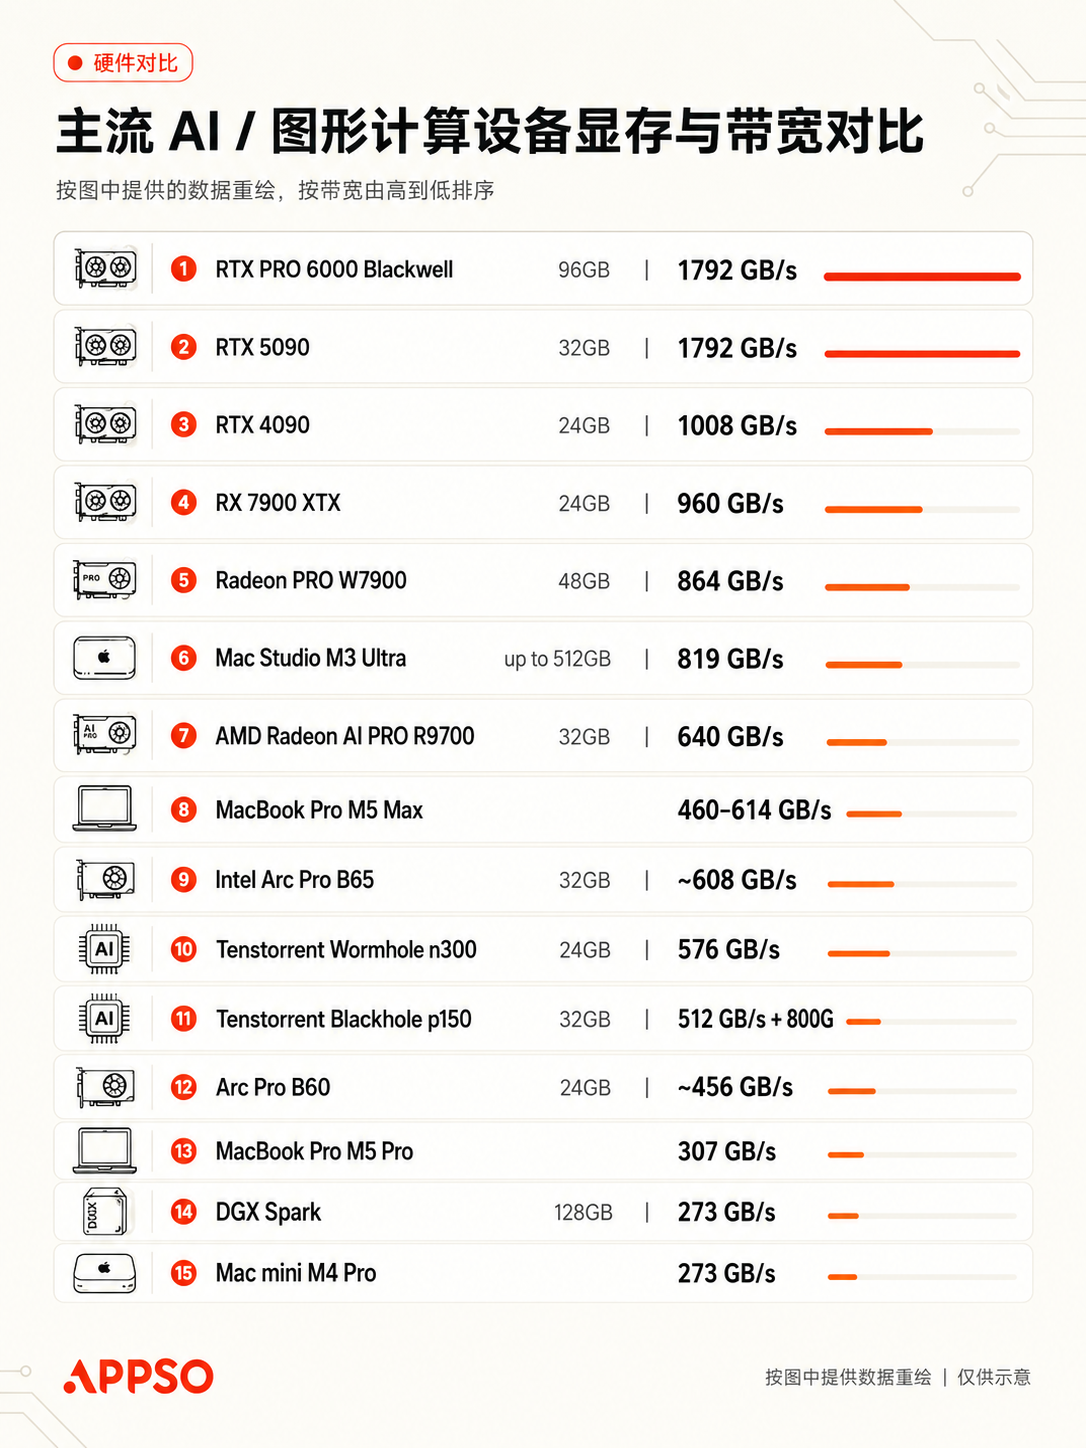
Za računala s 8 GB VRAM-a ili 16 GB obične memorije, najsigurniji izbor su mali modeli poput Phi-4 Mini 3.8B ili Qwen3.5 4B. Prikladni su za sažimanje, prevođenje, formatiranje i jednostavne pozive alata, a neće dovesti do nedostatka memorije na cijelom sustavu.
S 16 GB VRAM-a, uravnoteženiji izbor su Qwen3.5 9B i Gemma 4 12B. Gemma 4 12B podržava tekst, slike, audio i video, a Google je čak demonstrirao njezino pokretanje na laptopu s 16 GB RAM-a putem namjenskog AI Edge okruženja.
S 24 GB VRAM-a ulazi se u praktičnu zonu za lokalne Agent alate. Devstral Small 2 24B usmjeren je na programiranje i softversko inženjerstvo, a kao referentni hardver navodi se jedna RTX 4090 ili Mac s 32 GB memorije.
U istom rangu može se odabrati i uskoro otvoreni Qwen3.8 27B koji podržava tekstualni i vizualni unos te ima prednost u radu s kineskim jezikom.
S 32 GB VRAM-a moguće je pokrenuti Qwen3.5-35B-A3B. Taj model ima ukupno 35B parametara, ali aktivira samo oko 3B po tokenu — kad je u potpunosti smješten u VRAM, računalni teret manji je nego kod gustih modela sličnih ukupnih parametara.
Raspon od 80 do 128 GB predstavlja drugu granicu. gpt-oss-120b prema službenim podacima stane u jednu GPU s 80 GB; ti modeli bolje odgovaraju radnim stanicama s velikom jedinstvenom memorijom, profesionalnim računalnim karticama ili sustavima s više kartica.
Kao primjer za DeepSeek V4 Flash, trenutno najcjelovitije javno verificirano rješenje je server s četiri GB300 kartice. Svaka GB300 ima 288 GB memorije, što ukupno daje oko 1,15 TB VRAM-a — daleko više od samih težina modela, a ostatak se koristi za KV Cache, DSpark, dugi kontekst i istovremene zahtjeve.
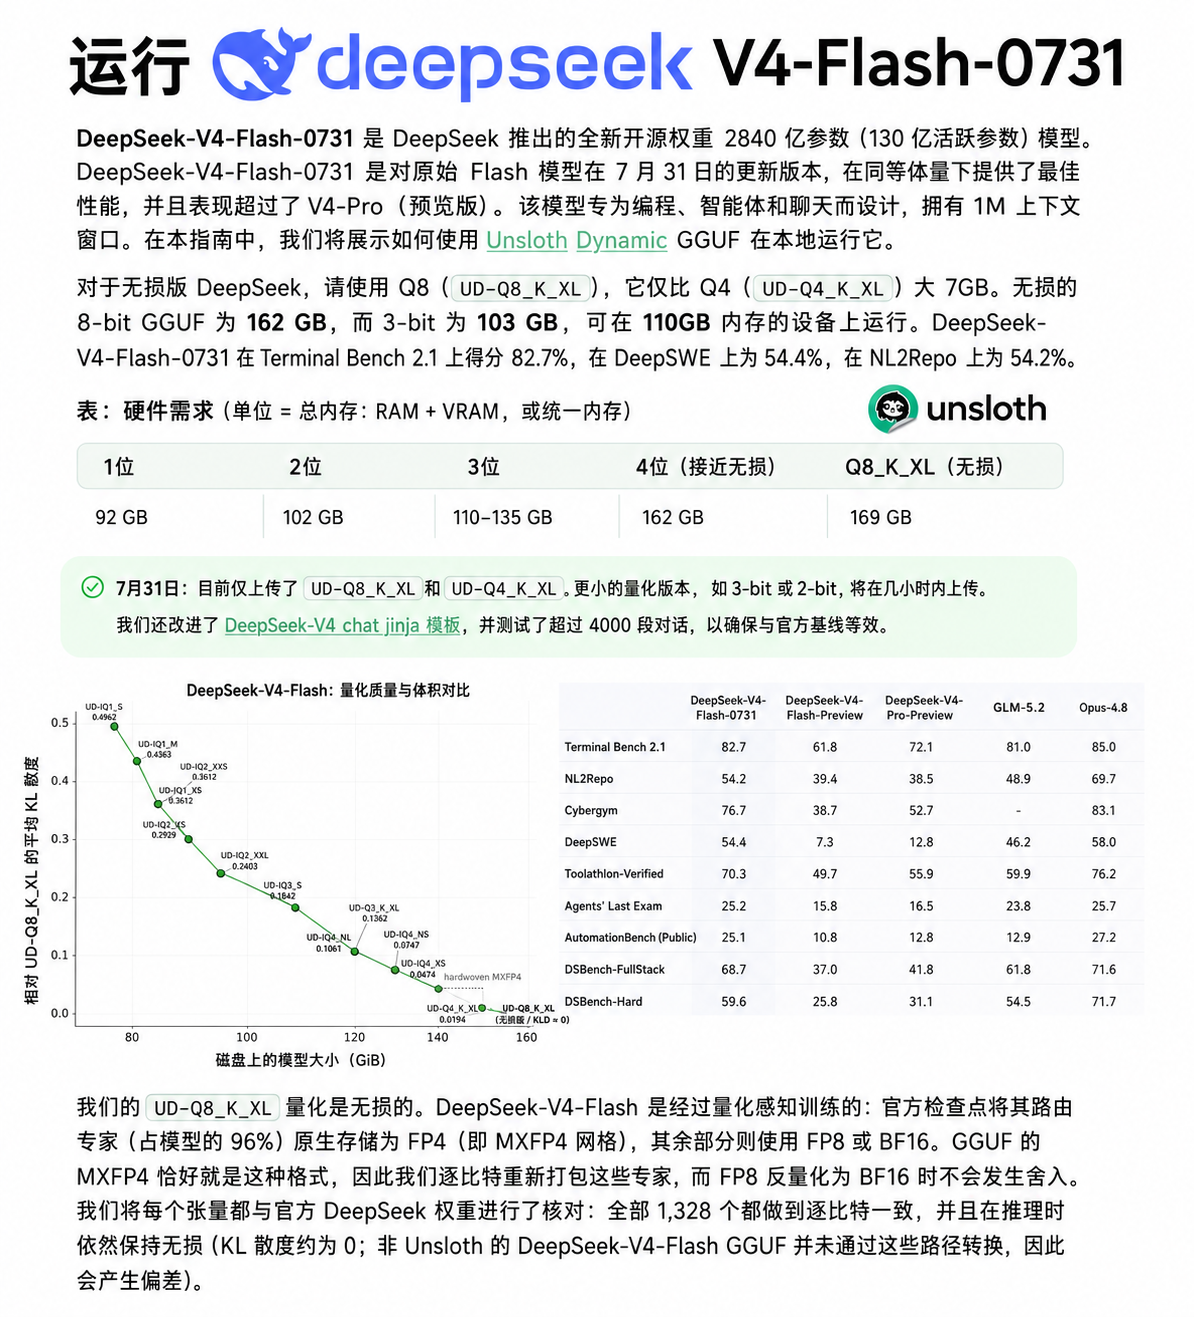
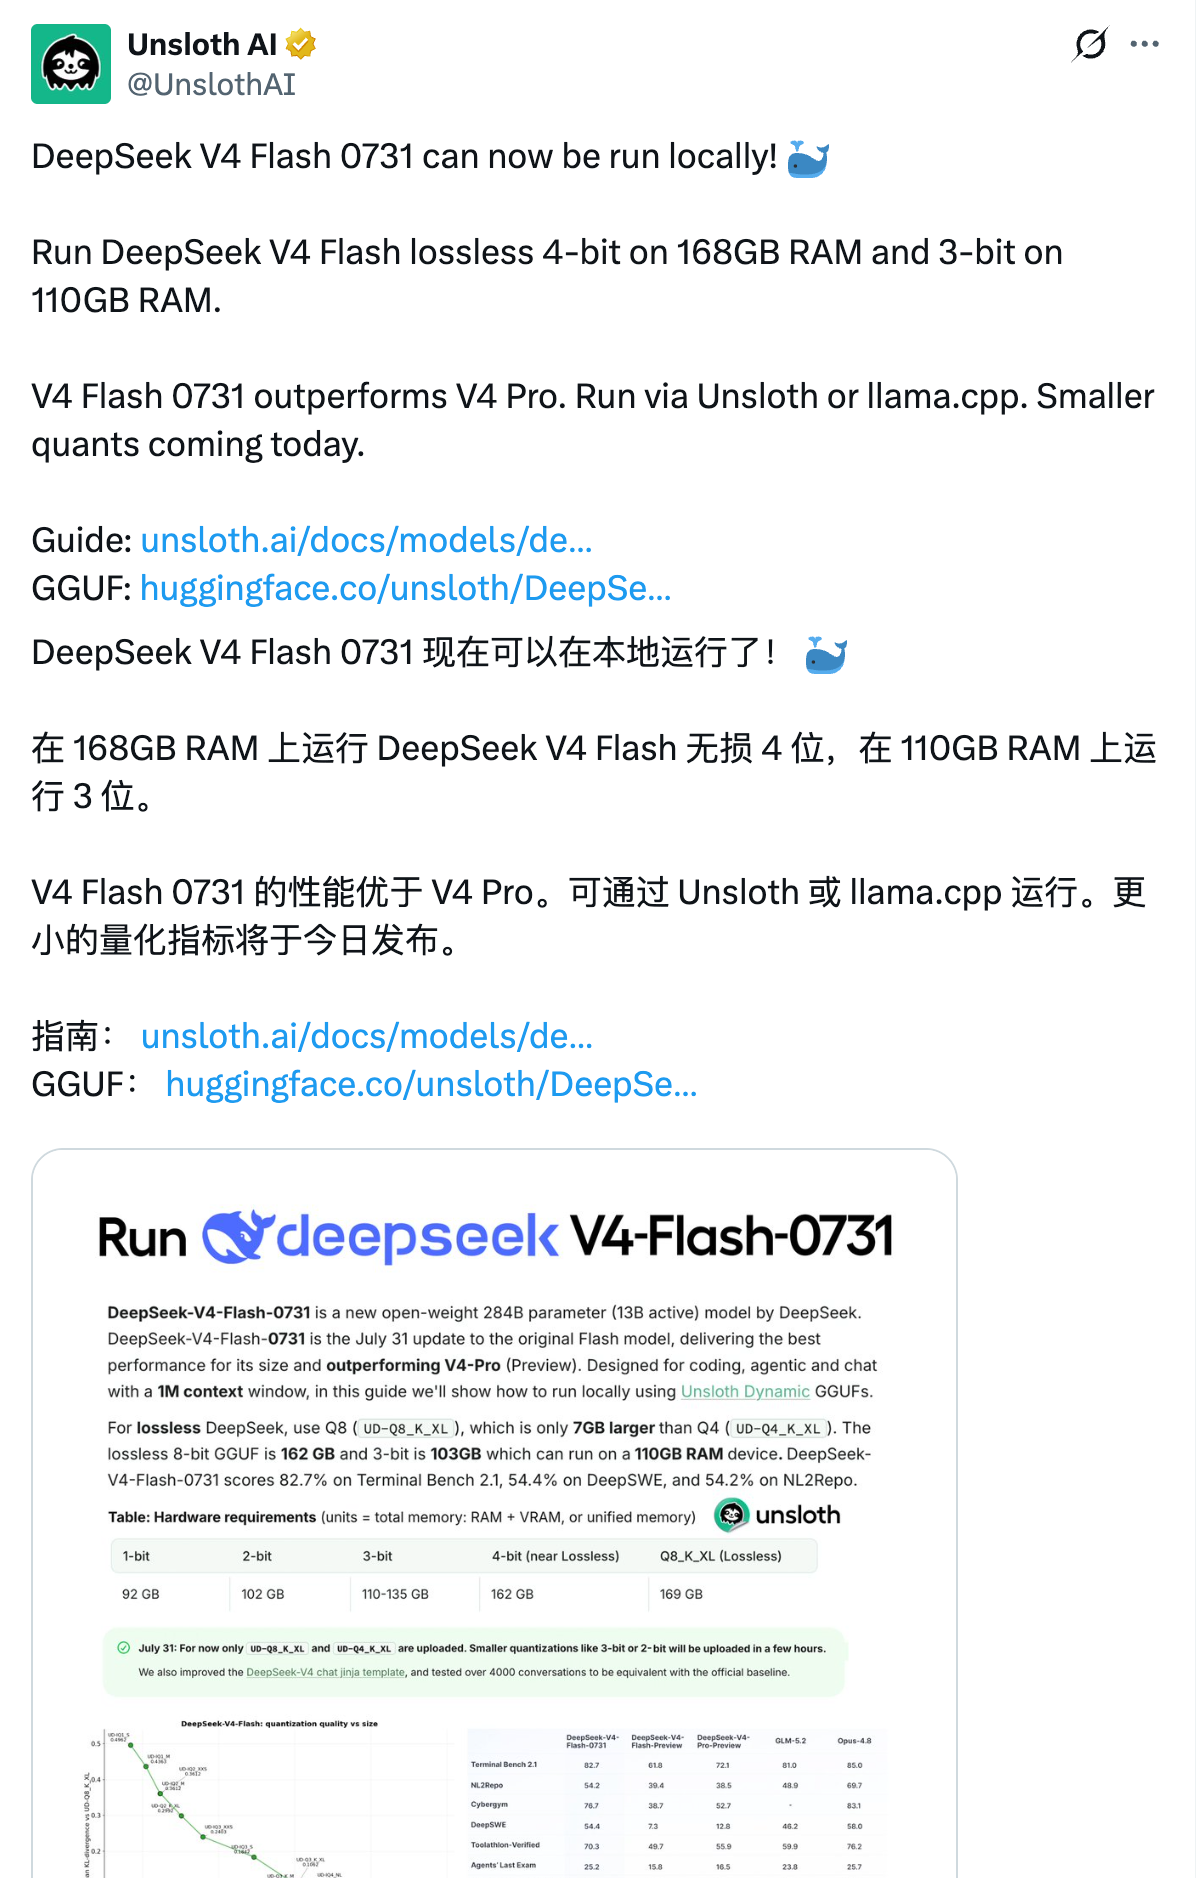
Neka kvantizirana rješenja iz zajednice omogućuju pokretanje DeepSeek V4 Flash bez gubitaka u 4-bitnoj kvantizaciji na 168 GB RAM-a, odnosno u 3-bitnoj na 110 GB RAM-a.
Odabir pravog softvera za lokalni LLM
Nakon što je hardver odabran, sljedeći korak je alat za pokretanje.
LM Studio je najprikladniji za one koji se prvi put susreću s lokalnim modelima. Nudi potpuno grafičko sučelje za pretraživanje, preuzimanje i prebacivanje između modela, a prije učitavanja može se koristiti posebna naredba lms load --estimate-only za procjenu koliko memorije zahtijevaju model, kontekst, Flash Attention i vizualne komponente.
Ollama je prikladniji za programere. Nakon instalacije, model se pokreće naredbom ollama run, a može poslužiti i kao OpenAI-kompatibilni API koji se spaja s Open WebUI-jem, Cherry Studiom, editorima i raznim Agent alatima.

Vrijedi napomenuti da Ollama sada nudi i lokalne i oblačne modele. Modeli označeni oznakom „cloud” izračun premještaju na Ollama Cloud; ako su privatnost i rad bez interneta važni, treba provjeriti izvodi li se model u potpunosti lokalno.
llama.cpp pruža finiju kontrolu. Korisnici mogu precizno postaviti broj slojeva prenesenih na GPU, veličinu konteksta, kvantizaciju KV Cachea i broj niti, a mogu birati između CUDA-e, ROCm-a, Metala, Vulkana, SYCL-a i čistog CPU načina rada. Prikladan je za one koji žele istisnuti maksimum iz hardvera, raditi s GGUF formatom ili koristiti nestandardne uređaje.

Korisnici Maca mogu odabrati MLX-LM, koji je optimiziran za Apple Silicon i jedinstvenu memoriju te uz zaključivanje podržava kvantizaciju, fino podešavanje i distribuirano pokretanje.

Ako model treba istovremeno posluživati više korisnika ili je potreban formalni interni API, prikladniji su vLLM i SGLang. Podržavaju kontinuirano grupiranje zahtjeva i veću propusnost, ali njihovo okruženje za postavljanje obično je usmjereno prema Linux serverima.
Česta je zabluda da su Open WebUI i Cherry Studio alati za pokretanje modela — oni su zapravo samo sučelja koja se spajaju na pozadinske sustave za zaključivanje poput Ollame, llama.cpp-a ili vLLM-a.
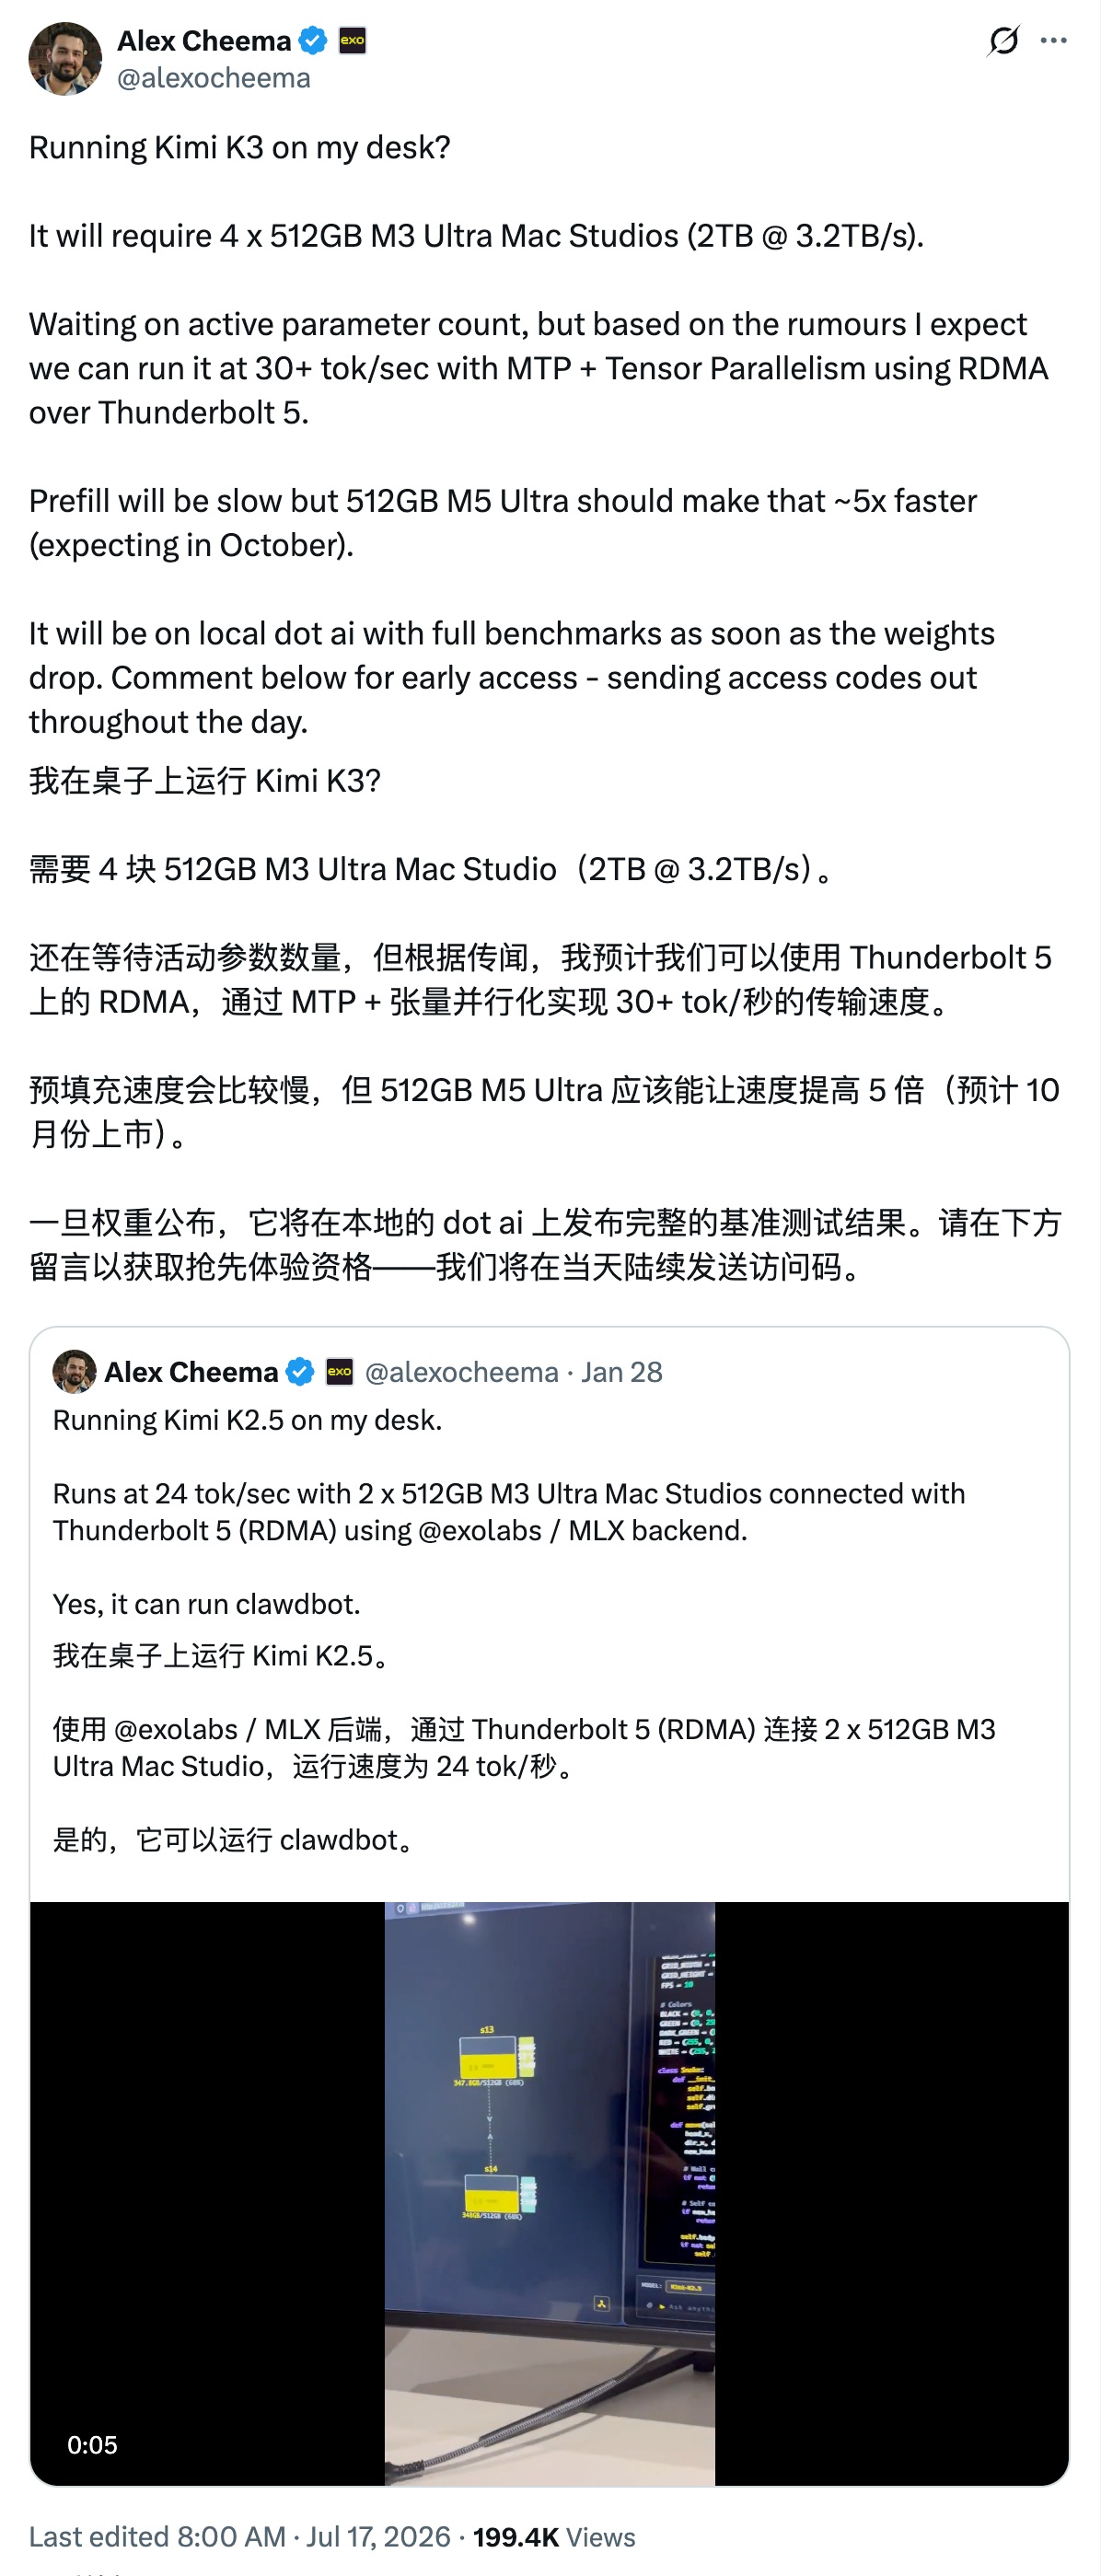
Neki kažu da je prava digitalna sloboda imati AI na vlastitom uređaju, bez ograničenja platforme.
Nema tjednih kvota, nema prekida usluge, nema straha od blokade računa. Kad proizvođač modela promijeni pretplatničke pakete, povuče verziju ili stegne uvjete korištenja, lokalni model i dalje nastavlja obrađivati vaše datoteke, kod i podatke.
No 2026. godine „lokalno pokretanje” treba sagledati kroz tri prizme:
Može raditi — znači da se težine mogu smjestiti u VRAM ili učitavati s diska sloj po sloj. Može se koristiti — znači da su brzina, kontekst i sposobnosti modela dovoljni za obavljanje zadataka. Vrijedi postaviti — znači da ušteda na API troškovima ili dobivena privatnost, stabilnost i kontrola opravdavaju troškove hardvera, struje i održavanja.
Pojava DeepSeek V4 Flash čini se da počinje zaokruživati taj trokut.
Model već postiže sposobnosti bliske vodećim zatvorenim modelima, a nakon kvantizacije može se pokrenuti na 110 do 168 GB RAM-a — što je doseg Maca s 128 GB jedinstvene memorije ili DGX Sparka.

Takvi uređaji i dalje su skupi za prosječnog korisnika, ali u usporedbi s nekadašnjom potrebom za više profesionalnih računalnih kartica i serverskim ormarima, jaz između najmoćnijih modela i osobnog računala znatno se smanjio.
Daljnji napredak u tehnologijama poput MoE arhitekture, niskobiterne kvantizacije, rijetke pažnje i strujnog učitavanja težina vjerojatno će nastaviti snižavati troškove postavljanja, a uređaji s jedinstvenom memorijom donijet će sve veće modele na osobna računala.
Modeli koji danas zahtijevaju radnu stanicu vrijednu stotine tisuća kuna, za nekoliko godina možda će raditi na običnom računalu.
Izvor: Ifanr
Povezani članci
 Vaš sljedeći odnos mogao bi imati trećeg člana jer Twoo uvodi umjetnu inteligenciju između dvoje ljudi15.9.2026.
 19.98万元起,吉利银河战舰700开启预售,最高1129匹马力,还有三电机四驱
Od 199.800 juana, Geely Galaxy Battleship 700 počinje s prednarudžbom, maksimalno 1129 konjskih snaga, s tri motora i pogonom na sva četiri kotača15.9.2026.
 号称人类造的最后一个 AI 要来了,刷屏全网的 RSI 是什么
Navodno zadnja AI koju će stvoriti čovječanstvo dolazi, što je RSI koji je preplavil cijelu mrežu?15.9.2026.
 Uzbekistanov tehnološki potez: Zemlja se natječe za globalnu pozornicu s novom slobodnom zonom “Enterprise Uzbekistan”14.9.2026.


