


Aug 10, 2026
Ključne točke
- Projekt FineBooks, zajednička inicijativa Hugging Facea i EleutherAI-ja, testirao je 14 open-source OCR modela na više od 2.000 stranica povijesnih knjiga kako bi utvrdio koliko dobro mogu pretvoriti skenirane tekstove u čiste podatke za treniranje jezičnih modela.
- Manji modeli često su nadmašili veće, a najbolji je postigao točnost prepoznavanja znakova iznad 97 posto uz cijenu manju od dva američka dolara po tisuću stranica.
- Istraživači smatraju da je kvaliteta rezultata dovoljna za treniranje AI modela, no napominju da su modeli još uvijek previše skloni pogreškama za primjenu u akademskim ili znanstvenim svrhama.
Projekt FineBooks tvrtki Hugging Face i EleutherAI testirao je 14 open-weight OCR modela na više od 2.000 stranica povijesnih knjiga. Najbolji modeli već proizvode tekst dovoljno kvalitetan za treniranje AI sustava, ali za akademsku primjenu još nisu spremni.
Treniranje open-source jezičnih modela na knjigama iz javne domene nosi sa sobom jedan ozbiljan problem: loš tekst. Knjižnice su te tekstove iz skenova izvlačile godinama pomoću optičkog prepoznavanja znakova (OCR), a rezultati su često puni pogrešaka. Projekt Talkie pokušao je izmjeriti koliko to zapravo šteti: jezični model treniran na OCR tekstu učio je svega 30 posto brzinom modela treniranog na ljudskim transkripcijama istih knjiga.
FineBooks, zajednički projekt Hugging Facea i EleutherAI-ja, istražio je mogu li današnji open-source OCR modeli riješiti taj problem. Tim je pokrenuo 14 open-weights modela na 2.165 stranica povijesnih knjiga i objavio rezultate u obliku ljestvice. Najbolji modeli postigli su točnost prepoznavanja znakova iznad 97 posto uz manje od dva dolara po tisuću stranica.
Milijuni stranica iz javne domene čekaju bolje prepoznavanje teksta
Kada su EleutherAI i njegovi partneri prošle godine objavili Common Pile – do tada najveći otvoreno licencirani korpus za treniranje – sadržavao je oko 300.000 knjiga iz javne domene s tekstovima dobivenim starijim OCR postupcima. Autori projekta FineBooks tvrde da je ponovna obrada tih knjiga boljim modelima jedan od najučinkovitijih načina za poboljšanje otvorenih skupova podataka za treniranje AI sustava.
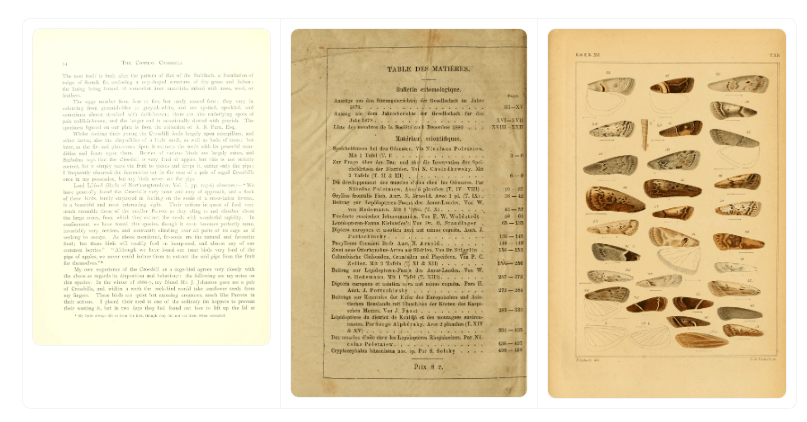
Kao prvu metu projekt je odabrao Biodiversity Heritage Library (BHL), koja čuva više od 300.000 digitaliziranih dokumenata o prirodnoj povijesti s ukupno više od 64 milijuna stranica. BHL svoju zbirku nudi za masovno preuzimanje putem AWS-a.
Za mjerenje kvalitete OCR-a potrebne su stranice s poznatim ispravnim transkripcijama. Tim je koristio materijale projekata IMPACT i BHL-Europe: između 2011. i 2012. stručnjaci su transkribirati šest BHL svezaka na engleskom, francuskom, njemačkom i latinskom jeziku s pogreškom od otprilike jednog znaka na 2.000. Ti su podaci dostupni pod CC-BY licencijom u GitHub repozitoriju i čine osnovu novog referentnog skupa podataka.
Manji modeli nadmašuju veće suparnike
Svih 14 modela slobodno je dostupno i može se pokrenuti na lokalnom hardveru bez API ključa. Mjerna veličina je stopa pogreške znakova (CER) – udio pogrešno prepoznatih znakova. Ljestvica razlikuje dvije inačice: „diplomatsku”, koja modernizaciju arhaičnih znakova poput dugog s (ſ) broji kao pogrešku, i „čitateljsku”, koja takve promjene tolerira.
Vodeći model dots.mocr koristi svega 3 milijarde parametara, dok Qwen3.5-9B postiže lošiji rezultat unatoč tome što je gotovo tri puta veći. OvisOCR2 zauzima drugo mjesto s tek 0,9 milijardi parametara i cijenom od 46 centi po tisuću stranica. Veličina modela i kvaliteta OCR-a za povijesne dokumente jednostavno ne koreliraju.
Evaluacija obuhvaća samo Antiqua tipografiju u četiri jezika. Ne uzima u obzir Fraktur, nelatinična pisma ni rukopise, a FineBooks je ograničen na stranice knjiga s jednim stupcem. Tim planira ponovno obraditi oko 200.000 BHL dokumenata iz javne domene jednim od najboljih modela i objaviti tekst kao otvoreni skup podataka. Novi se modeli kontinuirano dodaju na ljestvicu, a okvir za evaluaciju javno je dostupan.
Dovoljno dobro za treniranje AI-ja, ali preneprecizno za akademsku primjenu
Autori projekta FineBooks rezultate ocjenjuju prema namjeni. Za treniranje jezičnih modela, pišu, najbolji modeli već su dovoljno dobri. Proizvode znatno manje pogrešaka od starijih sustava, a ponovna obrada zbirke veličine BHL-a financijski je izvediva uz izmjerene troškove.
Knjižnice se, međutim, suočavaju s drugačijim problemom, napominje tim. Njihovi sustavi oslanjaju se na ALTO XML, format koji uključuje koordinate pojedinih riječi. Novi modeli kao izlaz daju Markdown ili obični tekst bez položaja riječi, pa se ne mogu uklopiti u postojeću knjižničnu infrastrukturu.
Za akademske transkripcije točnost još uvijek nije dovoljna – no ne zato što modeli pogrešno čitaju znakove, nego što ih tiho moderniziraju, zamjenjujući dugo „s” ili ligature suvremenim ekvivalentima. Ciljano fino podešavanje moglo bi to riješiti, smatraju istraživači.
Izvor: The Decoder
Povezani članci
 Alibabin model otvorenih težina Qwen-Image-2.1 tvrdi da nadmašuje zatvorene modele u generiranju slika s tek 7 milijardi parametara21.9.2026.
 Qwen3.8-Omni-Flash podrezuje cijene Google-ovog Gemini Flasha dok istovremeno dostiže njegove multimodalne referentne vrijednosti20.9.2026.
 Istraživači sigurnosti koristili su Anthropicov Claude za hakiranje OpenAI-jevih internih sustava za manje od 72 sata19.9.2026.
 GPT-6 Astra uništava Pokemone, Factorio i Fallout 3, a zatim se urušava u uzgoj krumpira u Minecraftu nakon jednog lošeg Creepera18.9.2026.


