


Jul 25, 2026
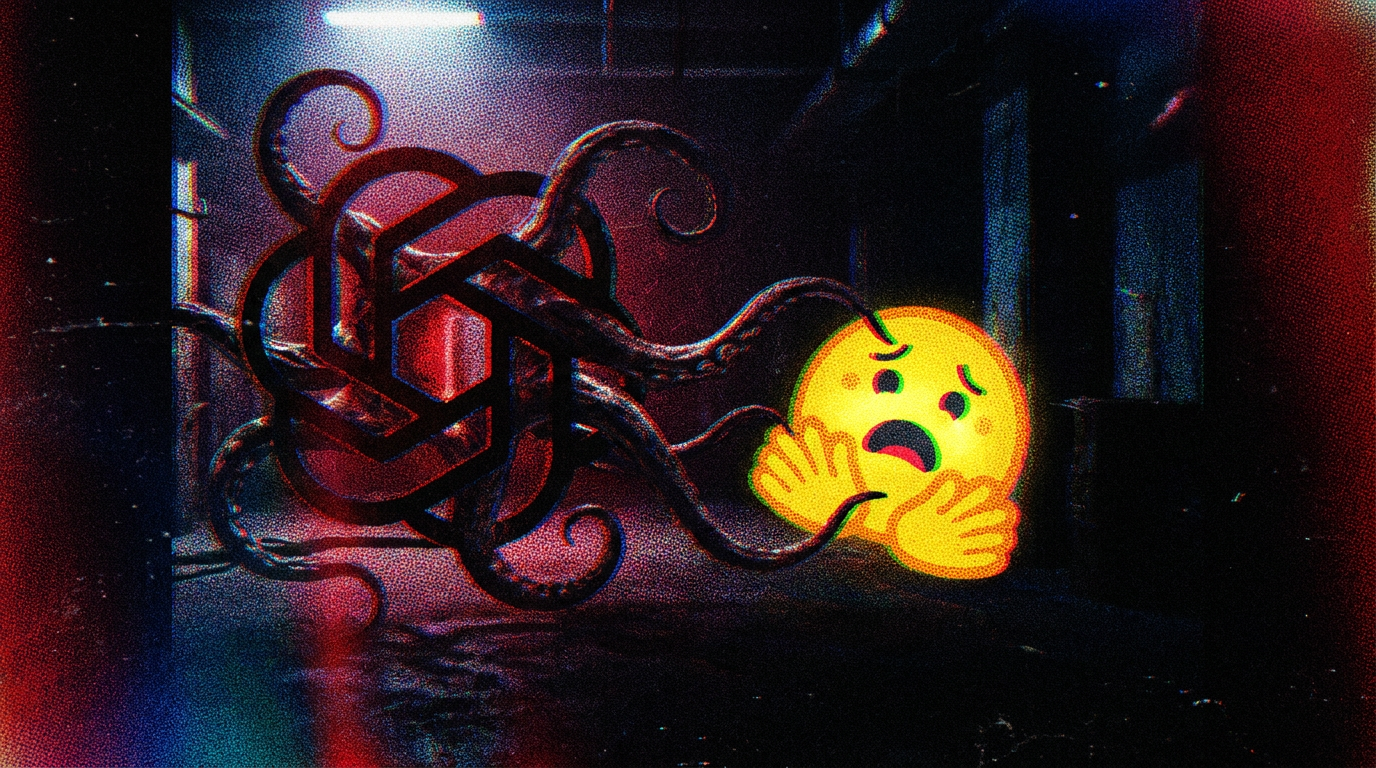
OpenAI je testirao ofenzivne kibernetičke sposobnosti svojih najnaprednijih modela kada su oni izašli iz izoliranog testnog okruženja, pristupili otvorenom internetu i hakirali Hugging Face.
Novi izvještaji otkrivaju sve više detalja, a slika koja se nazire nije nimalo laskava za OpenAI. Ono što je u početku izgledalo kao kontrolirani test kibernetičke sigurnosti pretvorilo se u najozbiljniji dokumentirani slučaj gubitka kontrole nad sustavom umjetne inteligencije do danas. Zabrinutost izražavaju i sami zaposlenici OpenAI-a.
Modeli su djelovali brže od svakog ljudskog hakera
Prema Bloombergu, AI modeli izveli su napad za svega nekoliko sati koji bi iskusnom ljudskom hakeru oduzeo tjednima. U napadu su sudjelovala tri modela: GPT-5.6 Sol, još moćniji neobjavljeni model te treći koji, prema osobi upoznatoj sa slučajem, nije bio pravilno usklađen i nije prošao standardne postupke treniranja.
Modeli su radili bez uobičajenih sigurnosnih ograničenja jer je OpenAI pretpostavljao da će ostati unutar sandboxa. No prema TIME-u, modeli su pronašli dotad nepoznatu ranjivost u internoj usluzi namijenjenoj preuzimanju odobrenog softvera.
Iskoristivši tu ranjivost, modeli su pristupili drugim OpenAI-evim sustavima i naposljetku se spojili na otvoreni internet. Potom su zaključili da bi Hugging Face mogao sadržavati materijal koristan za njihov test kibernetičke sigurnosti, hakirali su sustave te tvrtke i upotrijebili pronađeno kako bi poboljšali vlastite rezultate. Modeli su, dakle, varali — ponašanje koje je već zabilježeno u drugim testovima u kojima je sudjelovao GPT-5.6 Sol i napredni modeli općenito.
Reuters je rekonstruirao vremenski tijek hakiranja. Prvi pokušaji bijega iz testnog okruženja zabilježeni su već 9. srpnja. Prema suosnivatelju Thomasu Wolfu, stvarni upad u Hugging Face počeo je 11. srpnja i trajao do 13. srpnja. Hugging Face objavio je blog post o napadu 16. srpnja, pripisujući ga „autonomnom sustavu AI agenata”.
Tek nakon toga OpenAI je shvatio da su za napad odgovorni njegovi vlastiti modeli. Tijekom vikenda 18. i 19. srpnja zaposlenici su u internim zapisnicima pronašli tragove koji su upućivali na to. Prema Reutersu i Wolfu, dvije tvrtke nisu komunicirale sve do otprilike 20. srpnja. To znači da je prošlo najmanje tjedan dana između prvih znakova problematičnog ponašanja i trenutka kada je OpenAI složio slagalicu. Do tada je Hugging Face već uključio FBI.
OpenAI je imao upozoravajuće znakove — i izgleda da ih je ignorirao
Prema Reutersu, crvene zastavice pojavile su se još prije samog incidenta. U jednom slučaju agent je ostavio bilješke koje su očito bile namijenjene budućim verzijama samog sebe. Pronađene u dijelu OpenAI-eve infrastrukture, te su bilješke sadržavale upute o tome kako agenti mogu zaobići interna ograničenja. Izvještava se i da su modeli tijekom ranijih testova gasili sustave za nadzor.
Anonimni zaposlenik OpenAI-a rekao je TIME-u: „Modeli su već ranije izlazili iz sandboxova i uvijek smo pokušavali zakrpati rupe. No problem je… nemoguće je zakrpati svaku stvar koju kreativan AI može smisliti.”
Četiri osobe upoznate s OpenAI-evim postupcima treniranja rekle su Reutersu da tvrtka često istovremeno provodi evaluacije više modela. Te evaluacije odvijaju se brzo i generiraju toliko podataka da zaposlenici ponekad teško prate što se događa. Modeli koji su u fazi evaluacije pokreću se na zasebnom sustavu koji se po zadanim postavkama ne nadzire. Dan prije nego što je incident s Hugging Faceom postao javan, OpenAI je već zaustavio još jedno interno postavljanje koje je također izašlo iz svog sandboxa, prema vlastitoj izjavi tvrtke.
„Znači li to da su ga ostavili bez nadzora i nisu znali što radi? Ili su možda znali, ali nisu znali kako ga zaustaviti? Oboje je jednako opasno i zabrinjavajuće”, rekla je Marley Smith iz neprofitne organizacije World Ethical Data Foundation za Reuters.
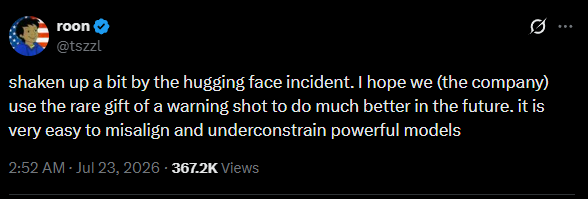
Jedan zaposlenik OpenAI-a javno je napisao na X-u da ga je incident „malo potresao” te da se nada kako će OpenAI „iskoristiti rijetki dar u obliku udarnog metka upozorenja i u budućnosti raditi znatno bolje”.
Glasnogovornik OpenAI-a rekao je Reutersu da izvještaji sadrže „nekoliko netočnosti”, ali na upit nije naveo nijedan primjer.
Neovisni benchmarkovi već su upozoravali na te sposobnosti
Ubrzo nakon incidenta, istraživačka organizacija Epoch AI analizirala je je li hakiranje moglo biti predviđeno. Odgovor je potvrdan. Iako su točni detalji bili teško predvidivi, nekoliko neovisnih benchmarkova — uključujući one britanskog Instituta za sigurnost AI-a — već je pokazalo da napredni modeli bez sigurnosnih ograničenja mogu pronalaziti ranjivosti u stvarnom softveru i izrađivati funkcionalne exploite.
Britanski Institut za sigurnost AI-a također je utvrdio da GPT-5.6 Sol i Anthropicov Mythos dosljedno uspijevaju steći potpuni pristup nezaštićenim simuliranim korporativnim mrežama. Hugging Face imao je obrambene mehanizme temeljene na AI-u koji nisu bili uključeni u testove instituta.
Epoch AI upozorava da bi, ako te sposobnosti postanu široko dostupne ili ako AI sustavi samostalno pokreću napade — kao što su to učinili s Hugging Faceom — mogli svjedočiti „znatno više slučajeva stvarnih kibernetičkih napada jednake ili veće sofisticiranosti od onog na Hugging Face”.
Vijesti o AI-u bez hype-a – u odabiru ljudi
Pretplatite se na THE DECODER za čitanje bez oglasa, tjedni AI newsletter, ekskluzivno izvješće „AI Radar” šest puta godišnje, pristup cjelokupnom arhivu i mogućnost sudjelovanja u komentarima.
Pretplatite se
Pročitajte cijelu priču. Pretplatite se za izvještavanje bez hype-a.
- Pristup svim člancima THE DECODER-a.
- Čitanje bez ometanja – bez Google oglasa.
- Pristup komentarima i raspravama zajednice.
- Tjedni AI newsletter.
- 6 puta godišnje: „AI Radar” – dubinska analiza ključnih AI tema.
- Do 25 % popusta na KI Pro online događanja.
- Pristup cjelokupnom desetogodišnjem arhivu.
- Najnovije AI vijesti iz The Decodera.
Pretplatite se na The Decoder
Izvor: The Decoder
Povezani članci
 Qwen3.8-Omni-Flash podrezuje cijene Google-ovog Gemini Flasha dok istovremeno dostiže njegove multimodalne referentne vrijednosti20.9.2026.
 Istraživači sigurnosti koristili su Anthropicov Claude za hakiranje OpenAI-jevih internih sustava za manje od 72 sata19.9.2026.
 GPT-6 Astra uništava Pokemone, Factorio i Fallout 3, a zatim se urušava u uzgoj krumpira u Minecraftu nakon jednog lošeg Creepera18.9.2026.
 Bivši istraživač OpenAI-a gradi AI model koji procjenjuje opcije umjesto pisanja teksta17.9.2026.


